補遺: Hopfield模型とレプリカ法
Hopfield模型は、神経回路網をIsing模型として読むための、たいへんよくできた入口です。各ニューロンは発火するかしないかを表す2値変数で、統計力学の言葉ではスピンです。記憶したいパターンは相互作用
この模型のよいところは、物語が直感的でありながら、計算がすぐに本格的な統計力学へ入っていくことです。Hebb則で結合を作ると、ハミルトニアンはスピングラスに見えます。分配関数を計算しようとすると、Hubbard--Stratonovich変換、鞍点法、秩序変数、自己無撞着方程式が自然に現れます。記憶容量を問うと、レプリカ法が必要になります。さらに横磁場を入れると、量子Hopfield模型を通じて量子アニーリングの発想へ進みます。
1. 連想記憶をエネルギー最小化として見る
スピンを
とします。
記憶したいパターンを
と書きます。
Hopfield模型のハミルトニアンは
です。係数の規格化にはいくつかの流儀があります。記憶容量の議論へつなげやすい標準的な書き方では、Hebb則を
と置きます。
この結合は、パターン
状態
で測ります。
自己結合による定数を無視すれば、ハミルトニアンは
と書けます。ここでHopfield模型の意味が一気に見えます。エネルギーを下げるには、どれかの
コラム 2024大学院講義 第15回 0:05:00-0:11:00
ハバスト祭りから始まる最終回
第15回は、Hopfield模型そのものに入る前からHubbard--Stratonovich変換、つまりハバードストラトノビッチ変換の空気で始まります。長い名前なので、講義では親しみを込めて「ハバスト」と省略します。研究室や分野の中では、こうした計算手法の名前が短い符丁になり、それを聞いただけで「あ、今日はあの計算をやるんだ」と身体が反応することがあります。
講義の冒頭では、ハバードとストラトノビッチを「手元に用意して」、合図があったら変換を打つ、という冗談から始まります。正確には「ハバスト法」という正式な名前があるわけではありません。それでも、スピングラスやレプリカ法の計算に慣れた界隈では、二乗が出てくると自然にこの変換を打ちたくなる、という研究文化が語られます。
もちろん、名前の軽さに対して中身はまじめです。二乗を一次へほどき、離散的なスピン和を取りやすくします。Hopfield模型はこの変換の威力が見えやすい題材なので、最終回にふさわしい「ハバスト祭り」になります。
最終回の冒頭では、チャット欄の挨拶や試験明けの空気を受けながら、「今日はHopfieldの話であり、ハバスト祭りの日でもある」と場が作られます。ハバードストラトノビッチ変換を短く「ハバスト」と呼び、必要なところで変換を「打つ」という言い回しが、講義全体の合図になっています。
この呼び方は正式名称というより、研究室や周辺分野で自然に育った符丁です。長い名前を毎回言うのではなく、計算の型を共有している人たちの間で短く呼びます。すると、その言葉だけで「二乗を一次化するあの計算だ」と分かるようになります。
講義では、ハバードとストラトノビッチが独立に同種の計算を用いて物性の問題を扱ったことにも触れられます。そこから、スピングラスやレプリカ法の周辺でこの変換がよく使われ、いつの間にか親しみを込めた略称になっていった、という歴史の手触りが添えられます。
一方で、講師は「ただの積分変換です」とも強調します。響きだけで強そうに見えても、実体はガウス積分を逆向きに読む計算手法です。そこが大事で、魔法の言葉ではなく、二乗相互作用をほどくための具体的な道具として使います。
この雑談は、そのままHopfield模型の計算への導入になっています。Hebb則で作ったハミルトニアンは、オーバーラップの二乗を含みます。その二乗があるからスピン和が難しくなります。だからハバストを打つ。冗談のように始まった言葉が、そのまま本編の計算方針を表しているわけです。
さらに、二乗だけでなく高次の項を扱う拡張にも話が及びます。ガンマ関数を使えば三次、四次の項にも似た発想を広げられる。ここには、計算手法を単に覚えるのではなく、自分の問題に合わせて使い直してほしい、という研究者向けのメッセージがあります。
2. ランダムパターンの直交性
パターンが独立にランダムに作られているとします。各
になります。
この直交性があると、記憶パターン同士が互いに邪魔をしにくくなります。逆に、よく似たパターンをたくさん入れると、別々の記憶の谷が重なり、検索の途中で混ざった状態へ落ちやすくなります。実験的にHopfieldネットワークを動かして「思ったほどきれいに想起しない」ときは、パターンの直交性や相関を疑うのが第一歩です。
局所場を
と書くと、スピン
です。したがって
と更新すると、エネルギーは上がりません。これが非同期Hopfield更新の基本です。全体を一気に動かすのではなく、一つのスピンを選び、その場所で局所場にそろえる。すると系は少しずつエネルギーの谷へ下っていきます。
有限温度で少し揺らぎを入れるなら、熱浴型に
とすればよいです。
コラム 2024大学院講義 第15回 0:17:00-0:21:00
係数を合わせるのも物理である
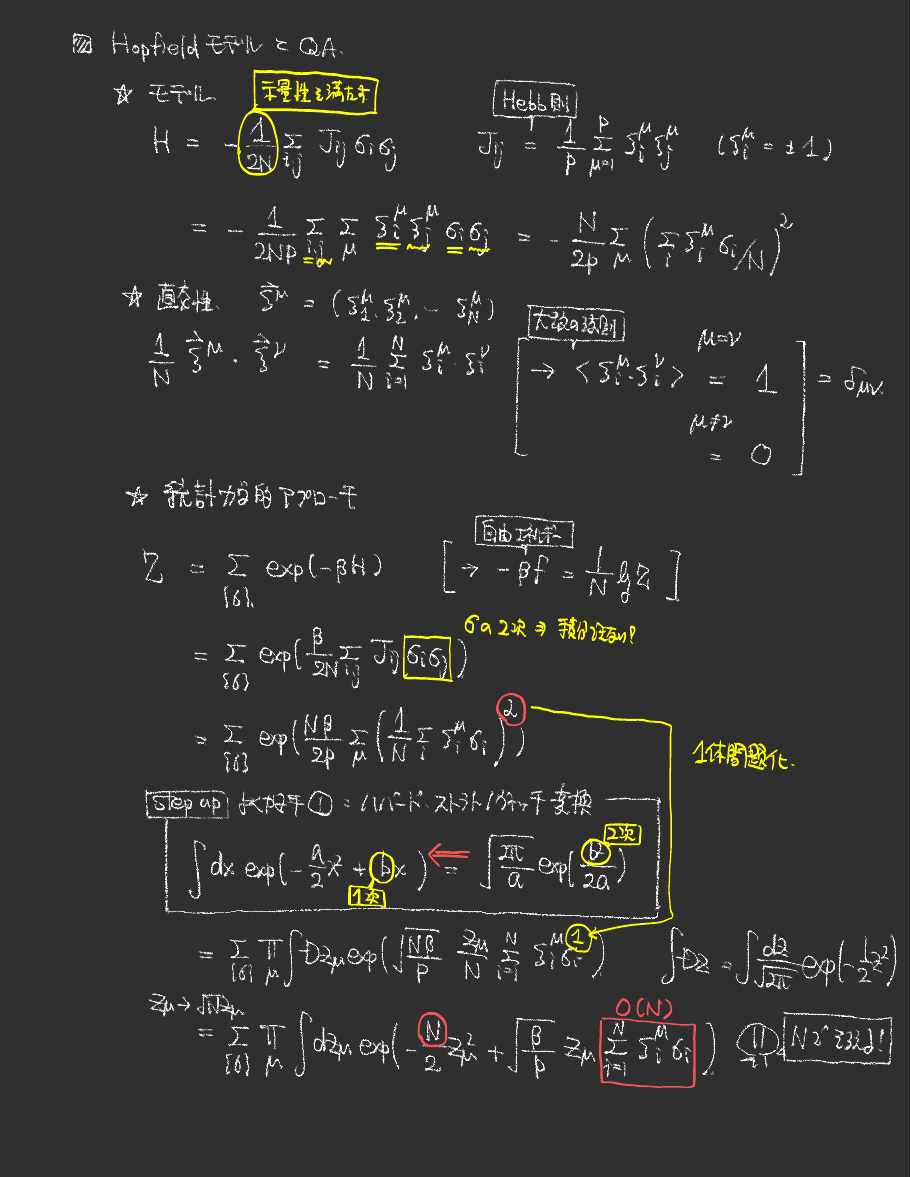
Hopfield模型の係数には、最初に見たときには細かすぎるように感じる因子が入ります。講義では、前回の板書に残っていた係数をその場で直しながら、なぜ $N$ や $P$ の入り方を気にするのかが説明されます。
理由は、エネルギーがスピン数に比例するようにしたいからです。$i,j$ の二重和はおよそ $N^2$ 個の項を持ちます。そこへHebb則の $1/N$ が入り、全体としてハミルトニアンが $O(N)$ になるように係数を整える。これがエネルギーの示量性です。
情報科学の問題には、もともと物理的なエネルギーがあるわけではありません。それでもエネルギー関数を作るなら、要素数を2倍にしたときに自由エネルギーも2倍になるような、熱力学的に自然なスケールへ整える必要があります。こういう地味な係数合わせが、あとで鞍点法を使える形を作ります。
この場面では、Hopfield模型のハミルトニアンに入る係数を修正するところから始まります。$i$ と $j$ の二つの添字で和を取るので、項数はおよそ $N^2$ です。そのままではスピン数に対して大きくなりすぎるため、結合や前係数でスケールを調整します。
狙いは、エネルギーがスピン数 $N$ に比例する形にすることです。物理では、体積や粒子数を2倍にしたらエネルギーも2倍になる、という示量性を大切にします。Hopfield模型でも、ニューロン数を増やしたときに自由エネルギー密度が意味を持つよう、ハミルトニアン全体を $O(N)$ にそろえます。
講義では、こうした修正は現場でよく起こる、と語られます。情報科学の問題を統計力学で解析するとき、まず問題設定の骨格を作り、そのあとで $N$ なのか $\sqrt N$ なのか、どこに $1/N$ を入れるのかを点検します。細かい係数に見えても、熱力学極限を取るときには決定的に効きます。
ここで重要なのは、オーバーラップが経験平均として書かれていることです。$\frac1N\sum_i \xi_i^\mu\sigma_i$ のような平均量を二乗し、それに $N$ をかけると、ハミルトニアンは自然に $O(N)$ になります。平均値を秩序変数にし、全体量を示量的にするという統計力学の作法が見えます。
このスケール合わせは、あとで鞍点法を使うための準備でもあります。指数関数の肩に $N$ 倍された関数を作ると、$N\to\infty$ で最大寄与だけを見ればよくなります。係数を直す作業は、単なる板書の訂正ではなく、計算を可能にするための設計なのです。
情報科学の数理モデルでは、エネルギーは実在する物理量というより、解析のために設計する関数です。だからこそ、どんな規格化にするかを自分で責任を持って決める必要があります。ここに、物理の言葉を情報科学へ持ち込むときの慎重さがあります。
3. 分配関数とHubbard--Stratonovich変換
平衡状態を調べるには分配関数
を計算します。上のoverlap表示を使えば
です。難しさは、
正の定数
が成り立ちます。右辺の
各パターン
となります。ここで決定的なのは、スピンについて一次になったことです。
です。したがって
とまとめられます。ただし
です。
から
を得ます。これは自己無撞着方程式です。右辺に現在の
ランダムパターンについて平均的な性質を見たいなら、経験平均を期待値に置き換えて
と書きます。ここで
コラム 2024大学院講義 第15回 0:23:00-0:35:00
積分するように見せて、最後は微分する
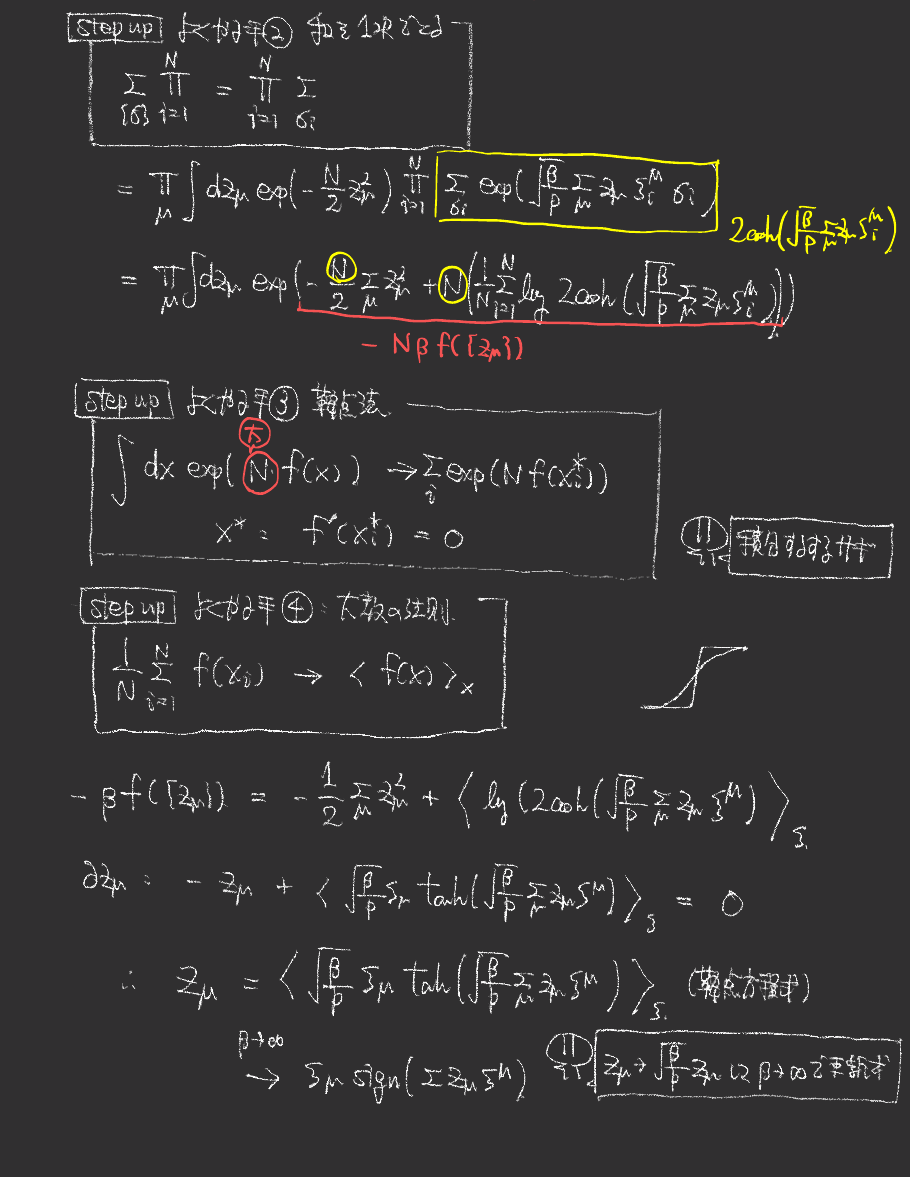
Hubbard--Stratonovich変換は、積分を増やすので一見すると遠回りです。けれども、離散スピンの全列挙より、連続変数の積分のほうが扱いやすい場面があります。微分できる、複素積分の道具が使える、そして大きな $N$ では鞍点法が使えるからです。
講義では、ガウス積分を普通に左から右へ実行するのではなく、右から左へ読む、と説明されます。計算済みの積分公式を逆向きに使うことで、二乗項を補助変数に線形結合した形へ置き換える。スピン和を取りたい今の目的から見ると、積分を一つ増やしてでも二乗をほどく価値があります。
ここでの作戦は、二乗を一次にほどき、スピン和を取り、指数の肩を $N$ 倍の形にそろえ、最後に鞍点を探すことです。積分を持ち込んだのに、熱力学極限では微分して代入するだけになります。この少しずるい感じが、統計力学の計算を軽くしてくれます。
この区間では、分配関数の中に現れるスピン和をどう処理するかが丁寧に説明されます。$\sigma_i=\pm1$ のすべての組合せを入れて足し上げるのが分配関数ですが、二乗項や高次項が残っていると、各スピンを独立に足し上げることができません。
そこでHubbard--Stratonovich変換を使います。ガウス積分を左から右へ実行すれば普通の積分計算ですが、講義ではそれを右から左へ読みます。すでに分かっているガウス積分の公式を逆向きに使い、二乗を補助変数との一次結合へ変えるわけです。
積分を増やすのは、普通なら面倒に見えます。しかしここで本当にやりたいのはスピン和です。離散的な $\pm1$ の総和は組合せ爆発しますが、連続変数の積分ならガウス積分、複素積分、鞍点法などの道具が使えます。難しさを、扱いやすい種類の難しさへ移し替えているのです。
講義では、ガウス測度を $\int Dz$ と書く記法も導入されます。毎回 $\frac{dz}{\sqrt{2\pi}}\exp(-z^2/2)$ と書く代わりに、重み付き積分をひとまとまりの記号として扱います。こういう記法の省略は、計算を見通すための足場になります。
その後、補助変数 $z_\mu$ を $\sqrt N z_\mu$ のようにスケールし直します。これにより、指数関数の肩に $N$ 倍された関数が現れます。$N$ が大きいと、その関数の最大点、すなわち鞍点が支配的になります。
ここで講義の調子は、若い頃に習う置換積分や部分積分から、研究で使う鞍点法へ移ります。積分を最後まで真面目に実行するのではなく、指数関数的に大きくなる寄与だけを見つける。すると、積分問題が微分して停留条件を解く問題へ変わります。
この一連の話は、Hopfield模型だけに閉じません。情報科学の問題に統計力学を持ち込むとき、どの量を $O(N)$ にそろえ、どの変数を秩序変数にし、どこで鞍点法を使えるようにするかが重要です。ハバストは、その全体設計の中心にある変換です。
4. Hopfield更新式が出てくる
自己無撞着方程式の意味を見ます。右辺の
は、サイト
は、複数の記憶パターンを重み付きで足し合わせた、サイト
低温極限
なので、自己無撞着方程式は
になります。これは、現在の状態がどの記憶パターンに近いかを測り、その重みを更新する式です。Hopfieldの非同期更新は、スピンそのものを局所場にそろえる形で書かれますが、熱力学的な鞍点方程式からも同じ連想記憶の構造が見えます。
一つのパターンだけが凝縮している、つまり
を得ます。これは平均場Ising模型と同じ形です。
複数の
コラム 2024大学院講義 第15回 1:09:00-1:15:00
HopfieldからTransformerを覗く
Hopfield模型の更新式は、「いまの状態がどの記憶に近いか」を測り、その記憶を強める計算です。この見方を少し現代的に言い換えると、queryが現在の状態、keyが記憶パターン、valueが取り出したい内容に対応する、と読むことができます。
低温極限で $\tanh$ が符号関数に近づくと、更新式は「どのパターンを思い出しかけているか」を選び、対応する重みを強める式になります。講義では、この $z_\mu$ をvalue、パターン $\xi^\mu$ をkey、現在の状態をqueryとして読むと、self-attentionの感覚が見えてくる、とつながれます。
もちろん、1982年のHopfield模型がそのままTransformerだった、という話ではありません。ただ、たくさんの候補の中から重みをつけて取り出し、自己強化しながら状態を更新するという本質は、現代のattention機構へつながる直感を与えてくれます。古い模型が、いまの大きな模型を見るためのレンズにもなるわけです。
この場面では、鞍点方程式から出てきた式と、Hopfieldネットワークの連想記憶の更新式が同じ形を持つことが確認されます。$\beta$ を大きくすると $\tanh$ は急な関数になり、最終的には符号関数に近づきます。つまり、平均場の式が低温では「局所場の符号にそろえる」更新式へ変わります。
講義では、この更新を「いま思い出しかけているものはどのパターンか」と読むことができます。いろいろな記憶パターンに重みをつけて足し合わせ、その符号を見て、もっとも近い記憶を強めていきます。連想記憶は、記憶候補の重み付けを自己強化するダイナミクスとして見えます。
ここからTransformerへの話が入ります。queryは、いまの状態から投げられる問いです。keyは、比較対象となる記憶パターンです。valueは、その記憶をどれだけ取り出すかを表す重みです。Hopfield模型の $z_\mu$ と $\xi^\mu$ をこの言葉で読み替えると、self-attentionの直感に近づきます。
もちろん、Hopfield模型がそのまま現在のTransformerである、という単純な同一視ではありません。違いは大きいです。けれども、たくさんの候補の中から重要度を計算し、その重みを使って状態を更新するという中核には、はっきりした共通感覚があります。
講義では、現代の大規模モデルが難しい構造を増やすより、単純な足し算と掛け算を大量に回す方向へ進んだことにも触れられます。GPUのような並列計算機に合う形で、softmaxや行列積をひたすら回す。複雑な知能のように見えるものが、意外に単純な演算の反復から立ち上がるという見方です。
この雑談の教育的な意味は、古い模型を古いまま終わらせないところにあります。Hopfield模型を学ぶことは、1980年代のニューラルネットワーク史を知るだけではありません。現代のattentionや生成AIを、統計力学の言葉で眺め直す入口にもなります。
5. 記憶容量とレプリカ法
ここまでの計算では、記憶パターン数
と置きます。
さらに難しいのは、パターン
レプリカを
です。このあとパターン平均を取り、サイト方向の和を整理すると、レプリカ間の重なり
が自然に出ます。
一つの記憶パターンを想起している相では、そのパターンとの重なり
も必要です。
もっとも単純な仮定は、レプリカのラベルによらない解を考えることです。
これをレプリカ対称解と呼びます。この仮定のもとでは、Hopfield模型の記憶相を記述する自己無撞着方程式は、代表的に
と書けます。ただし
です。
この式はよくできています。
零温での古典Hopfield模型では、記憶相が保たれる上限は
です。つまり、ランダムなパターンなら、おおよそ
コラム 2024大学院講義 第15回 1:32:00-1:36:00
対称性を仮定し、破れたら戻ってくる
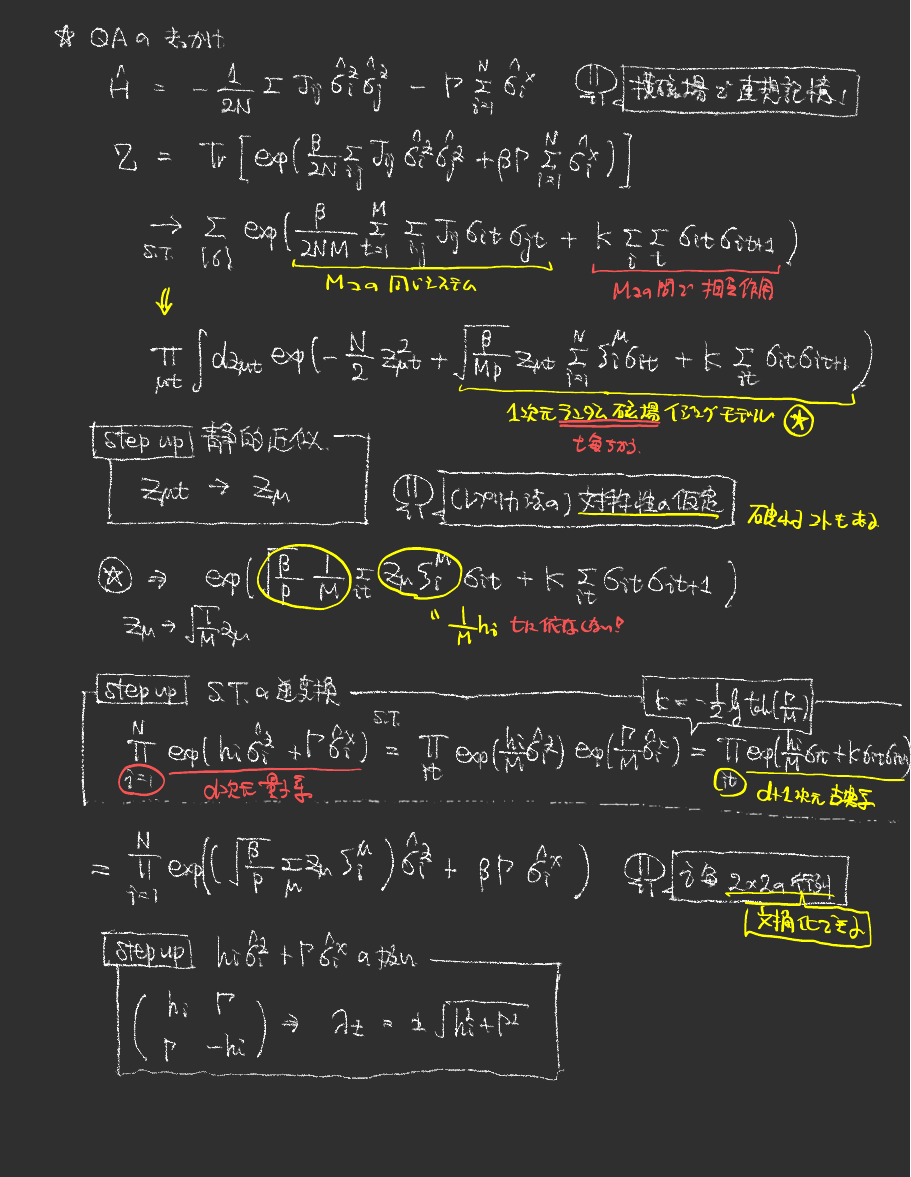
量子系をTrotter分解すると、同じ系のコピーが虚時間方向に並びます。横磁場の効果は、隣り合うTrotterスライス間の相互作用として現れます。そのため、量子Hopfield模型は、コピーが並んだ古典的なランダム場Ising模型として読めます。
ここで静的近似を入れると、補助変数 $z_{\mu,t}$ は虚時間 $t$ に依存しない、と仮定されます。ランダム系のレプリカ法でも、同じ系のコピーを用意し、まずレプリカ番号によらない解を考えます。コピーを導入する理由は違いますが、「コピーの添字によらない解をまず仮定する」という姿勢はよく似ています。
もちろん、仮定は仮定です。レプリカ対称性や静的近似がいつでも正しいわけではありません。少しずらして安定性を調べ、破れが見えたら、より細かい構造へ戻ります。この往復が、スピングラスの計算を単なる形式操作で終わらせないための態度になります。
この区間では、量子Hopfield模型をSuzuki--Trotter分解で古典系へ写したあと、どこが難しいのかが説明されます。Trotter方向にコピーされたスピン $\sigma_i^t$ は、隣の時刻スライスと相互作用します。さらに、各サイトにはパターンに由来する場所依存の磁場がかかります。
そのため、厳密には一次元ランダム場Ising模型のような問題を解く必要があります。一次元だから簡単、とは限りません。場所ごとに磁場が違い、Trotter方向の相関も持つので、スピン和は一気に複雑になります。
標準的な進め方として、講義では静的近似が導入されます。補助場 $z_{\mu,t}$ は本来Trotterスライス $t$ ごとに違ってよいのですが、まず $t$ に依存しない $z_\mu$ と置きます。虚時間方向に動かない、静的な解を仮定するわけです。
この発想は、レプリカ法におけるレプリカ対称解とよく似ています。レプリカ法では、同じ乱れを持つコピーを複数用意し、最初にレプリカ番号によらない解を仮定します。Trotter分解とレプリカ法ではコピーの意味が違いますが、「コピー方向に一様な解から始める」という姿勢が共通しています。
ただし、対称性はいつでも守られるわけではありません。レプリカ対称性が破れることもあれば、静的近似が十分でない場合もあります。講義では、仮定した値を微小量 $\delta$ だけずらし、Taylor展開して安定性を見る、という考え方が示されます。
ずらした成分が消えていくなら、その対称な仮定は安定です。逆に、微小なずれが増幅されたり、二次の係数が不安定になったりするなら、より細かい構造を考えなければなりません。ここが、対称性を仮定して楽をすることと、仮定を検査することの境目です。
Parisiによるレプリカ対称性の破れの話にも触れられます。ランダム系は、単一の谷ではなく、多数の谷や階層的な構造を持ちます。Hopfield模型を量子化して解析する計算の途中にも、そのスピングラス的な発想が顔を出します。
6. 量子Hopfield模型
Hopfield模型に横磁場を入れると、量子Hopfield模型になります。スピンをPauli行列へ置き換え、
とします。第一項は記憶パターンを焼き込む古典的なHopfield相互作用、第二項は各スピンを反転させる横磁場です。
分配関数は
です。
ここで
に変わります。
この形にすると、量子Hopfield模型は「虚時間方向に
古典Hopfield模型と同じように、各スライスに補助変数
となります。ここで静的近似
を置くと、Trotter方向に依存しない有効場だけが残ります。すると、Suzuki--Trotter分解を逆向きに読むことができ、各サイト
という一スピン問題になります。
です。したがって、自由エネルギーは
になります。鞍点方程式は
です。
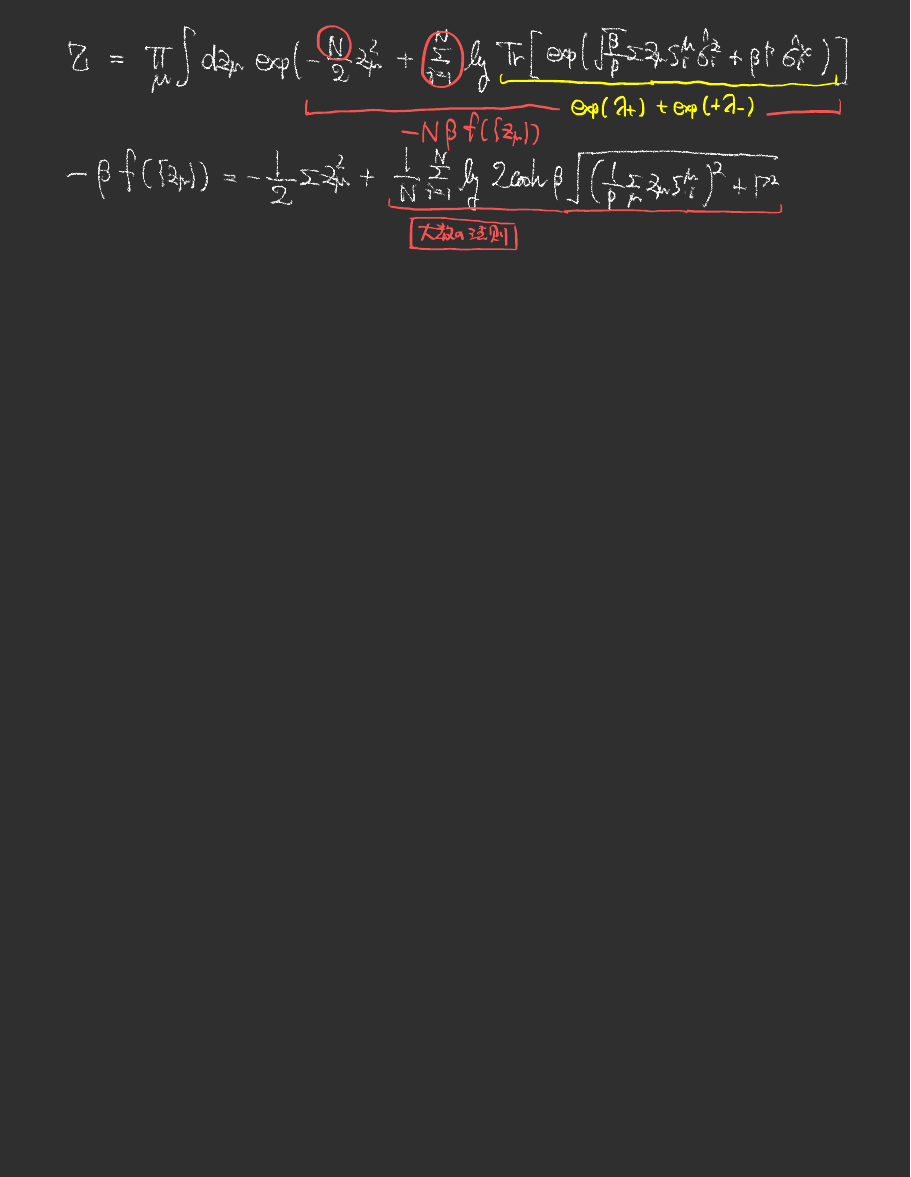
7. 量子アニーリングへの接続
量子Hopfield模型では、横磁場
ここで
Nonomura--Nishimoriの量子Hopfield模型では、横磁場の強さと温度が巨視的性質に似た役割を果たすことが示されます。熱ゆらぎを下げることで記憶へ落ちる古典的な絵と、横磁場を下げることで記憶へ落ちる量子的な絵が、相図の水準でよく対応します。この対応が見えると、量子アニーリングは単に「量子版の最適化法」というだけでなく、情報統計力学の中から自然に生まれた方法として読めます。
コラム 2024大学院講義 第15回 1:23:00-1:36:00 / 1:41:00-1:57:00
横磁場を連想記憶にかける
Hopfield模型に横磁場を入れる発想は、いま見ると自然に見えるかもしれません。けれども、連想記憶を量子力学の重ね合わせで動かしてみる、という発想には、当時ならではの勢いがあります。プラスかマイナスかで迷うスピンを、横磁場で本当に迷わせて、その揺らぎを情報処理に使うわけです。
講義では、Nonomura--Nishimoriの量子Hopfield模型が、量子アニーリングの源流の一つとして語られます。古典スピンをPauli行列へ置き換え、横磁場を入れ、重ね合わせ状態から連想記憶を行わせる。アイデアは軽やかに見えますが、その解析はレプリカ法とスピングラスの計算でどっしり支えられています。
期待されたほど記憶容量が劇的に増えたわけではありません。それでも、横磁場が単なる邪魔なノイズではなく、探索や連想記憶に使える制御パラメータだと見えたことが大きいです。シミュレーテッドアニーリングの温度と、量子アニーリングの横磁場が、同じ数理の中で並んで見えてきます。
新しい研究は、いきなり巨大な一般論から出てくるとは限りません。一スピン、二スピン、有限個のパターン、そして熱力学極限へ進みます。その積み上げの先に、量子アニーリングのような分野の入口が開きます。
講義では、Hopfield模型を紹介した理由が、量子アニーリングの源流にあるからだと明かされます。古典的な $\pm1$ スピンをPauliの $\hat\sigma^z$ に置き換え、そこへ横磁場 $\Gamma\hat\sigma^x$ をかける。これにより、記憶パターンを古典的に選ぶだけでなく、重ね合わせの中から連想記憶を行う量子Hopfield模型が現れます。
Nonomura--Nishimoriの仕事は、その発想をレプリカ法やスピングラスの方法で解析したものとして位置づけられます。講義では、今の目から見ると軽やかでポップに見える発想でも、計算そのものは一つ一つどっしり進められている、と語られます。面白そうだから横磁場をかける。しかし、かけたあとには、きちんと相図や記憶性能を調べます。
量子系になった瞬間、分配関数は単なるスピン和ではなくトレースになります。そこでSuzuki--Trotter分解を使い、量子系を $M$ 個のコピーを持つ古典系へ写します。各TrotterスライスにはHopfield模型があり、隣り合うスライス同士は横磁場に由来する相互作用 $K$ で結ばれます。
この見方をすると、横磁場のある量子スピン系は、虚時間方向に一つ次元が増えた古典系として扱えます。コピーをたくさん並べる、補助場を入れる、静的近似を置きます。ここで、量子モンテカルロ、レプリカ法、ハバストが同じ計算の部屋に入ってきます。
さらに講義では、Suzuki--Trotter分解を逆向きに読む発想も示されます。ハバストがガウス積分を逆向きに読むのと似て、Trotter方向に並んだ古典スピン列を、縦磁場と横磁場を受ける一スピン量子問題へ戻す。もとの二体相互作用は、補助場によって一体問題へ分解されているので、最後は $2\times2$ のPauli行列を対角化すればよいです。
この対角化から、固有値は $\pm\sqrt{h_i^2+\Gamma^2}$ の形になり、トレースは $2\cosh\{\beta\sqrt{h_i^2+\Gamma^2}\}$ を生みます。$\Gamma=0$ に戻すと古典Hopfield模型の式が再現され、$\Gamma$ があると量子ゆらぎを含む自由エネルギーになります。ここまで来ると、量子Hopfield模型の更新式も鞍点条件から作れます。
期待されたほど記憶容量が劇的に増えたわけではない、という冷静な評価も語られます。それでも重要なのは、横磁場がただの邪魔なノイズではなく、情報処理を進める制御パラメータとして読めるようになったことです。スピンが $+1$ か $-1$ かで迷う状況を、横磁場で本当に迷わせ、最後に横磁場を弱めて答えを確定させます。この発想が量子アニーリングへつながります。
講義の結びでは、量子アニーリングは思いつきで突然出てきたものではない、と強調されます。一スピン、二スピン、有限サイズ、熱力学極限、古典と量子の比較を丁寧に積み上げる。その中で「似ているけれど違う、違うけれど似ている」構造を見つけるから、新しい分野を提案する勇気が生まれます。
さらに、現代のTransformerや大規模モデルを量子系で見たら何が起こるか、という問いも投げかけられます。Hopfield模型からTransformerを眺め、そこに横磁場を入れます。省電力化や新しい計算様式の可能性まで含めて、古典的な連想記憶模型がいまの研究にもつながる題材として置かれます。
8. 反強磁性横相互作用による相転移の制御
横磁場を入れた量子Hopfield模型では、
まず、
とします。このとき目的ハミルトニアンは
です。
です。最後は
計算の流れは、この補遺で何度も見てきたものと同じです。各Trotterスライス
そしてデルタ関数とフーリエ積分表示で、
を挿入します。こうすると、全結合相互作用は
になります。角括弧
であり、反強磁性XX項が横磁化を押し返す形で入ります。
鞍点方程式は
です。式だけを見ると重く見えますが、意味は単純です。縦方向では、記憶パターンとどれだけ重なっているかを測ります。横方向では、量子ゆらぎがどれだけ残っているかを測ります。その二つの釣り合いを、自由エネルギーの最小点として決めています。
記憶を一つだけ取り出す相では、ある一つの
多数の記憶パターンを入れると、事情が少し変わります。
のように書けます。
この多数パターンの場合、
この結果は、Hopfield模型の見方を少し変えます。横磁場を入れるだけなら、熱ゆらぎと量子ゆらぎを比べる量子版連想記憶です。反強磁性XX項まで入れると、記憶の谷へどう近づくかを設計するハミルトニアン工学になります。記憶容量だけを増やす話ではありません。自由エネルギー地形をなめらかにし、途中で大きな壁をまたがない道を作れるかどうかを見る話です。
9. 読み終えるための整理
Hopfield模型を、レプリカ法の例として読むと、次の流れが見えます。
- 記憶パターン
をHebb則で結合 に焼き込む。 - 状態と記憶の重なり
を秩序変数にします。 - ハミルトニアンを
の形に直し、記憶がエネルギーの谷になることを見ます。 - Hubbard--Stratonovich変換で二乗を一次にほどき、スピン和を取ります。
が大きい極限で鞍点法を使い、自己無撞着方程式を得ます。 では、自由エネルギー平均のためにレプリカ法を使います。 - レプリカ対称解から、記憶信号
とクロストークノイズの競争を見ます。 - 横磁場を入れると、Suzuki--Trotter分解、静的近似、量子アニーリングへの接続が現れます。
- 反強磁性横相互作用を入れると、記憶の谷へ向かう途中の自由エネルギー地形を設計できます。
この流れは、単にHopfield模型だけの計算ではありません。Boltzmann machine、誤り訂正符号、圧縮センシング、量子モンテカルロ、量子アニーリング、そして現代的なattention機構まで、情報を持つ多数自由度系を統計力学で見るときの基本姿勢になっています。難しい問題を前にしたとき、まず秩序変数を探し、二乗をほどき、大きな
参考文献
- Yuya Seki, Hidetoshi Nishimori, “Quantum annealing with antiferromagnetic transverse interactions for the Hopfield model,” Journal of Physics A: Mathematical and Theoretical 48, 335301 (2015). 出典
- Yuya Seki, Hidetoshi Nishimori, “Quantum annealing with antiferromagnetic fluctuations,” Physical Review E 85, 051112 (2012). 出典
- J J Hopfield, “Neural networks and physical systems with emergent collective computational abilities,” Proceedings of the National Academy of Sciences 79, 2554–2558 (1982). 出典
- Daniel J. Amit, Hanoch Gutfreund, H. Sompolinsky, “Spin-glass models of neural networks,” Physical Review A 32, 1007–1018 (1985). 出典
- Daniel J. Amit, Hanoch Gutfreund, H. Sompolinsky, “Storing Infinite Numbers of Patterns in a Spin-Glass Model of Neural Networks,” Physical Review Letters 55, 1530–1533 (1985). 出典
- Hidetoshi Nishimori, Yoshihiko Nonomura, “Quantum Effects in Neural Networks,” Journal of the Physical Society of Japan 65, 3780–3796 (1996). 出典
- Hubert Ramsauer, Bernhard Schäfl, Johannes Lehner, Philipp Seidl, Michael Widrich, Lukas Gruber, et al., “Hopfield Networks Is All You Need,” International Conference on Learning Representations (ICLR) (2021). 出典