雑談
講義中に挟まれた歴史談、研究文化、講義準備の裏話、質疑の流れを一覧できます。各項目を押すと、講義ノート本文中の該当コラムへ移動します。
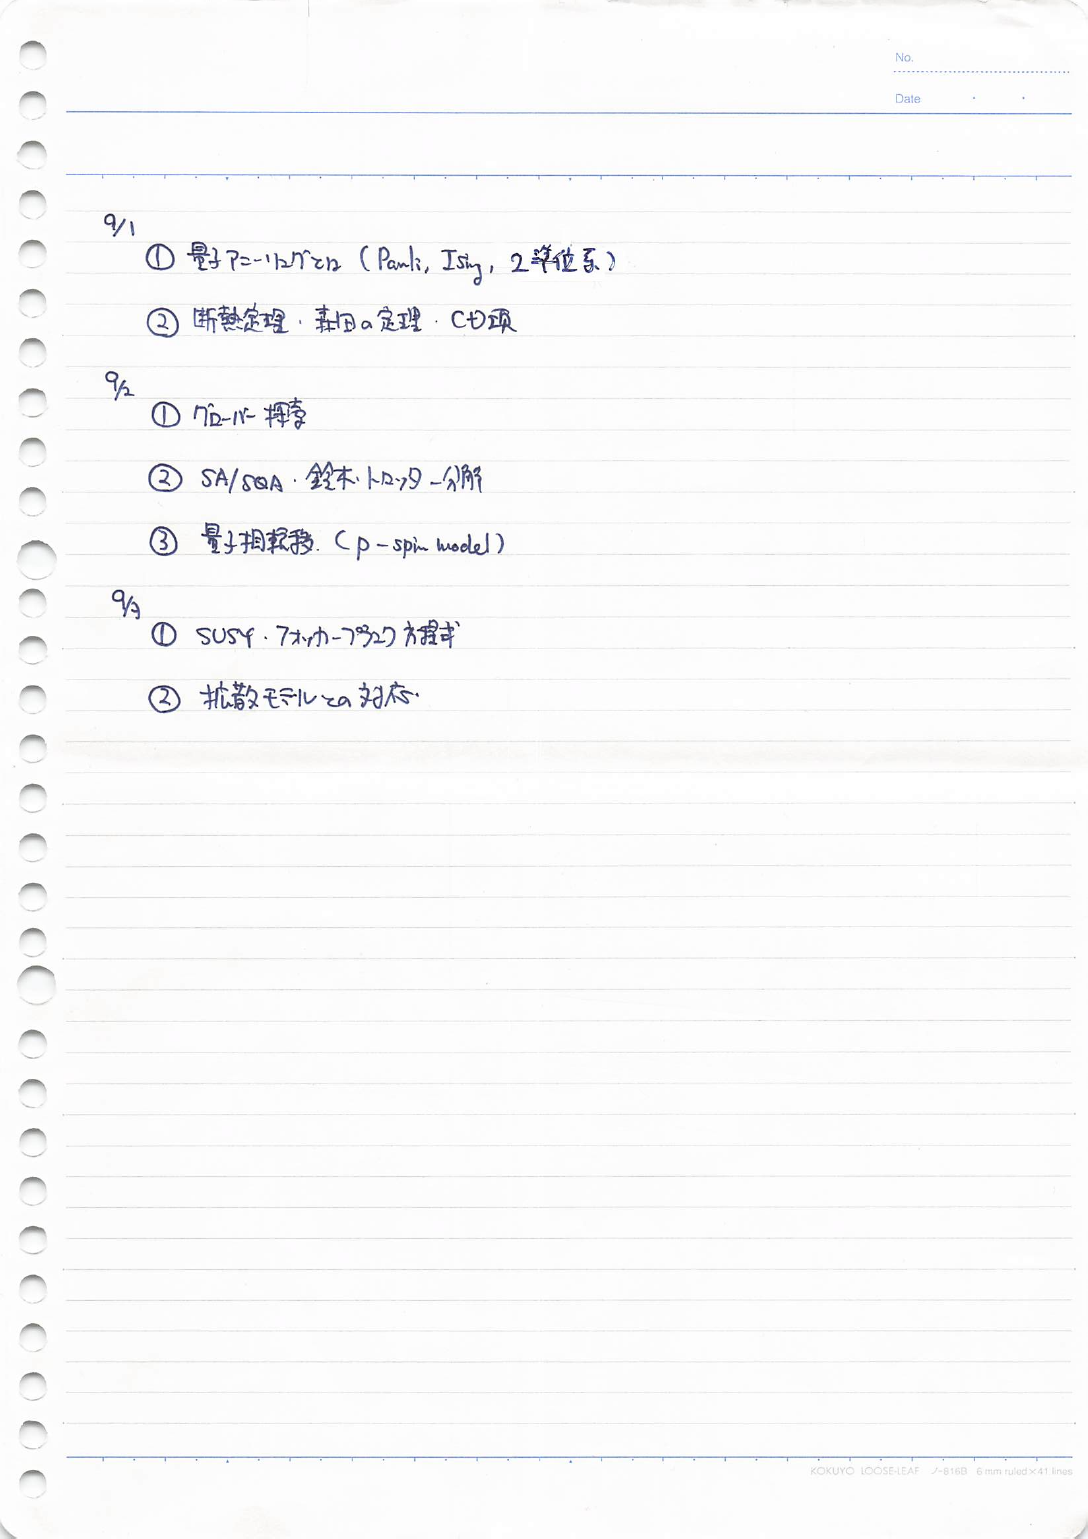
1日目: 量子アニーリングの基礎
冒頭では、この集中講義を黒板だけで終わらせず、YouTube Liveのアーカイブとして残す意図が語られました。対面の板書講義のよさを保ちつつ、受講者があとから何度も戻れるようにする、という設計です。
冒頭では、この集中講義を黒板だけで終わらせず、YouTube Liveのアーカイブとして残す意図が語られました。対面の板書講義のよさを保ちつつ、受講者があとから何度も戻れるようにする、という設計です。
コロナ禍以後、講義記録が残ることの価値は大きくなりました。PC上の手書き板書とコメント欄での質問を組み合わせることで、3日間の集中講義そのものが「あとで参照できる研究ノート」に近づいています。
全体像として、1日目は量子アニーリングと断熱定理、2日目はHopfield模型・量子モンテカルロ・鈴木-トロッター分解、3日目は虚時間Schrodinger方程式・Fokker-Planck方程式・拡散モデルへ進む、と予告されました。
この場面では、まず集中講義そのものをYouTube Liveで残す理由が話されています。黒板で行う対面講義の熱量を保ちつつ、あとから板書や議論を見返せる形にすることが狙いです。配信では名前やコメントが残る一方、質問をその場で受けられるので、受講者がノートを取りながら参加できる余地も作られています。
東京科学大学で2年に1回担当している集中講義であり、今回は量子アニーリングを正面から扱う、と導入されます。量子アニーリングは東京工業大学・東京科学大学の物理学系にとって歴史的にも縁が深く、門脇・西森の仕事から続く流れを、研究史も含めて語れる題材として選ばれています。
3日間の見取り図もここで示されます。初日は量子アニーリングの基礎、断熱定理、森田・西森のスケジュール、反断熱項へ進み、2日目は統計力学・量子モンテカルロ・鈴木-Trotter分解、3日目は虚時間Schrodinger方程式、Fokker-Planck方程式、拡散モデルへ向かうという流れです。講義を単なる入門で止めず、現在進行形の研究に接続する意図も強調されています。
講義では、量子アニーリングを「量子力学のダイナミクスを使って組合せ最適化問題を解くためのアルゴリズム」として導入しています。ここでの主役は、抽象的な量子計算そのものではなく、解きたい問題をエネルギー最小化として読み替える手続きです。
講義では、量子アニーリングを「量子力学のダイナミクスを使って組合せ最適化問題を解くためのアルゴリズム」として導入しています。ここでの主役は、抽象的な量子計算そのものではなく、解きたい問題をエネルギー最小化として読み替える手続きです。
門脇・西森の提案が触れられ、Ising模型の基底状態を求めることが最適解を得ることに対応する、という基本線が確認されました。経路探索やナップサック問題のように、0/1またはプラス・マイナス1の離散変数が増えると候補が爆発する、という実感からこの定式化に入ります。
ここでは、量子アニーリングが何を目的に生まれたのかが短く整理されます。量子力学の時間発展を使って組合せ最適化問題を解く、というのが基本の発想であり、解きたい問題をハミルトニアンのエネルギー最小化として表すところから話が始まります。
門脇・西森による1998年前後の提案が紹介され、孤立量子系のSchrodinger方程式に従うダイナミクスを念頭に、問題ハミルトニアンの基底状態を得ることが最適解を得ることに対応すると説明されます。ここで重要なのは、量子計算の抽象的な言葉よりも、スピン配置と目的関数を対応させる統計力学的な見方です。
経路探索やナップサック問題のような離散的な選択問題は、変数の数が増えると候補数が爆発します。その膨大な候補を一つずつ調べるのではなく、エネルギー地形として持ち込み、低い場所を探すという視点が量子アニーリングの入口になります。
シミュレーテッドアニーリングの「パラメータをゆっくり変えると低エネルギー状態へ行きやすい」という直観が、量子アニーリングにも流れ込んでいます。ただし、横磁場の強さは大きければよいわけではなく、目的ハミルトニアンのエネルギースケールと合わせる必要があります。
シミュレーテッドアニーリングの「パラメータをゆっくり変えると低エネルギー状態へ行きやすい」という直観が、量子アニーリングにも流れ込んでいます。ただし、横磁場の強さは大きければよいわけではなく、目的ハミルトニアンのエネルギースケールと合わせる必要があります。
また講義では、Ising模型が唯一の表現ではないことも補足されました。原理的には、目的関数を何らかのハミルトニアンに埋め込み、それと可換でないドライバーを用意できればよいです。Ising形式が中心になったのは、スピングラス理論との接続と、二準位系として実装しやすい物理的事情が大きい、という説明です。
この質疑では、横磁場の強さやIsing模型以外の表現可能性が話題になります。量子アニーリングは、単に量子力学から突然出てきたわけではなく、熱ゆらぎを使うシミュレーテッドアニーリングの直観を背景にしています。パラメータをゆっくり変えれば低エネルギー状態へ到達しやすい、という考え方が量子版にも持ち込まれます。
横磁場の大きさについては、十分大きければ何でもよい、というわけではありません。目的ハミルトニアンの係数やエネルギースケールとドライバーハミルトニアンのスケールが大きくずれると、補間中に一方だけが支配的になり、ちょうどよい遷移の場面を作りにくくなります。実際には問題のスケールに合わせる必要があります。
Ising形式は非常に便利ですが、唯一の入口ではありません。目的関数をハミルトニアンとして表し、それと可換でないドライバーを用意できれば、原理的には別の模型でも同じ発想を組み立てられます。Ising模型が中心に置かれるのは、スピングラス理論との接続、二準位系としての実装のしやすさ、そして最適化問題への翻訳の明快さがあるためです。
門脇・西森の量子アニーリングでは、横磁場を強くしておき、それを0へ下げる書き方が自然に現れます。一方でFarhiらの量子断熱計算、AQCでは、補間パラメータを0から1へ動かす書き方が前面に出ます。
門脇・西森の量子アニーリングでは、横磁場を強くしておき、それを0へ下げる書き方が自然に現れます。一方でFarhiらの量子断熱計算、AQCでは、補間パラメータを0から1へ動かす書き方が前面に出ます。
講義中の歴史談では、量子アニーリングの提案が先にあり、その経緯を西森先生が国際会議などで丁寧に説明し続けたことが紹介されました。数式としては同じような補間を扱っていても、何を強調して名づけるかで研究コミュニティの見え方が変わる、という好例です。
ここでは、量子アニーリングと量子断熱計算の歴史的な違いが語られます。門脇・西森の量子アニーリングでは、強い横磁場から始め、それを弱めていくという書き方が自然でした。実験的にも「横磁場をかけて切る」という絵で理解しやすい導入です。
一方、Farhiらの量子断熱計算では、初期ハミルトニアンと問題ハミルトニアンを0から1へ補間する形が前面に出ます。数式としては同じ構造を含みますが、AQC側は量子力学の断熱定理を強く意識し、ゆっくり変化させれば基底状態を追跡できるという説明を明確に打ち出しました。
講義では、どちらが先か、どちらの名前が広まったか、そして日本発の仕事が国際的な呼称の中でどう扱われたかにも触れられます。西森先生が国際会議などで量子アニーリングの経緯を粘り強く説明してきたことが紹介され、数式だけでなく研究文化や命名の力学も、この分野の歴史の一部として語られています。
終盤では、「断熱」という言葉が熱浴のない孤立系にも使われることへの違和感が話題になりました。ここでの断熱は、熱の出入りがないという日常語の意味よりも、ゆっくり変えて励起を起こさないという量子力学の慣習的な意味で使われています。
終盤では、「断熱」という言葉が熱浴のない孤立系にも使われることへの違和感が話題になりました。ここでの断熱は、熱の出入りがないという日常語の意味よりも、ゆっくり変えて励起を起こさないという量子力学の慣習的な意味で使われています。
森田・西森スケジュールは、その「ゆっくり」を一様な遅さではなく、非断熱遷移を起こしやすい場所で丁寧に通るための設計として読むと分かりやすくなります。ギャップが小さい場所が分かるならそこを遅く、分からなくても始点と終点の傾きを落とす、という発想です。
この場面では、「断熱」という言葉への違和感が取り上げられます。熱浴がない孤立量子系の議論なのに、なぜ断熱と呼ぶのかという問いに対し、ここでの断熱は熱の出入りではなく、ゆっくり変えて励起を起こさないという量子力学の慣習的な用語だと説明されます。
講義では、この違和感自体は自然なものだとも語られます。熱が出てこないなら断熱ではないのでは、と大学院生の頃に自分でも思ったし、セミナーで突っ込んだこともある、という笑いを交えながら、言葉に引っかかりすぎず数学的な内容を見るよう促しています。
そこからスケジュール改善の話へ移ります。ハミルトニアンの時間微分が非断熱遷移を生むなら、その微分や端点での寄与をうまく抑えれば、残留励起を小さくできるはずです。森田・西森スケジュールは、単に長く待つだけでなく、どこをどのようにゆっくり通るかを工夫する発想として導入されます。
1日目の最後には、翌日も13時20分開始、13時ごろから配信開始という案内がありました。大学院講義にYouTube Liveらしい反応が来るという軽い雑談もあり、硬い断熱定理の回が、翌日のQAOAと量子モンテカルロへ少し柔らかくつながって終わっています。
1日目の最後には、翌日も13時20分開始、13時ごろから配信開始という案内がありました。大学院講義にYouTube Liveらしい反応が来るという軽い雑談もあり、硬い断熱定理の回が、翌日のQAOAと量子モンテカルロへ少し柔らかくつながって終わっています。
1日目の締めでは、エネルギーギャップが一般には簡単に分からないこと、したがって断熱条件をそのまま実用的なスケジュール設計に落とすのは難しいことが確認されます。理論的には美しい条件があっても、実際に問題を解く場面ではギャップ推定そのものが困難になる、という量子アニーリングらしい難しさが残ります。
翌日の案内として、2日目も13時20分から始まり、13時ごろから配信する予定だと伝えられます。大学院講義でありながらYouTube Liveとして反応やスーパーチャットがあることへの驚きも語られ、硬い数式の講義が少しくだけた空気で閉じられます。
内容面では、1日目で連続時間の量子アニーリングと断熱追随を扱い、2日目にはQAOA、量子モンテカルロ、鈴木-Trotter分解へ進むという橋渡しになります。講義の終わり方自体が、連続時間の絵から離散的・統計力学的な絵へ移る予告になっています。
2024大学院講義からの補遺コラム
一定ポテンシャル中の平面波解から、Compton散乱の実験的感覚を経て、運動量演算子を導きます。
一定ポテンシャル中に電子や原子が置かれていると考え、定常Schrodinger方程式を二階線形微分方程式として解きます。ハミルトニアンは運動エネルギーの微分演算子と一定値 $V_0$ からなり、式を整理すると $E-V_0$ が運動エネルギーとして残ります。
この微分方程式の解は、右向きと左向きの平面波 $Ae^{ikx}+Be^{-ikx}$ です。代入してみると、二階微分が $-k^2$ を返し、$\hbar^2 k^2/(2m)+V_0=E$ という見慣れたエネルギー保存の形が出てきます。量子力学の式は急に神秘的になるのではなく、波を微分したときの性質から少しずつ組み上がっています。
では、この $k$ は何を意味するのでしょうか。講義では、Compton散乱を通して、光の波長変化と電子の反跳運動量を比べる発想が持ち込まれます。電子の運動量は磁場中の曲がり方から測れます。運動量保存を信じるなら、光にも $h/\lambda$、すなわち $\hbar k$ の運動量を割り当てなければならない、というわけです。
この実験的な見方を波動関数へ戻すと、運動量は波の肩にある $k$ を取り出す操作として現れます。$e^{ikx}$ を微分して $ik$ を出し、$-i\hbar$ を掛ける。こうして $-i\hbar\partial_x$ が運動量演算子になる、という導入は、波と粒子の二つの顔を同じ数式の中に置くための、ごく自然な手順になります。
位置表示と運動量表示をFourier変換でつなぎ、閉じ込めによる離散化をFourier級数として読みます。
位置と運動量は、古典力学のように同じ机の上に置ける量ではなく、Fourier変換で結ばれた二つの見方として現れます。位置の関数として波動関数を書くか、波数や運動量の関数として書くか。その移り変わりの中心に、微分を掛け算へ変えるFourier変換があります。
講義では、「量子力学はFourier変換だ」と言い切る勢いで、この見方が強調されます。もちろん量子力学のすべてがFourier解析に尽きるわけではありません。しかし、波で状態を表し、座標微分や時間微分から運動量やエネルギーを取り出す、という入口だけを見るなら、Fourier変換は非常に強力な地図になります。
さらに、量子力学の「飛び飛び」はFourier級数の側から見ると理解しやすくなります。無限に広がる空間では連続的な波数を積分しますが、有限区間や周期境界条件では、許されるモードを離散的に足し合わせます。箱の中に閉じ込めると波数が離散化し、その結果としてエネルギー準位も離散化する、という流れです。
古い教科書には、量子力学が作られた時代の手探りも一緒に残っています。講義では、その歴史的な混乱を怖がらず、むしろ冷静に読みほぐす態度が勧められます。Schrodinger方程式を見たときに、まず「これはどんな波をFourier的に分解しているのか」と考えると、量子化の入口がかなりなめらかになります。
状態を左右から挟んで作用を確かめ、掛け算と微分の順序差から交換関係を手で確認します。
交換関係は、抽象的な記号だけで覚えると遠く見えます。講義では、位置表示で状態 $\psi(x)$ を左右から挟み、$x$ を掛けてから微分する場合と、微分してから $x$ を掛ける場合を比べます。量子力学は「挟んでなんぼ」という言い方の通り、演算子の意味は状態に作用させて初めて手触りを持ちます。
計算は積の微分だけです。$\hat x\hat p\psi=x(-i\hbar\,d\psi/dx)$ に対して、$\hat p\hat x\psi=-i\hbar\,d(x\psi)/dx$ には余分な $\psi$ が出ます。この一項が残るため、$[\hat x,\hat p]\psi=i\hbar\psi$、つまり $[\hat x,\hat p]=i\hbar$ となります。厳密には右辺は恒等演算子倍ですが、物理では文脈が明らかなときに単位演算子を書かないことがよくあります。
続いて反交換子 $\{\hat A,\hat B\}=\hat A\hat B+\hat B\hat A$ が導入されます。Hermitian演算子どうしなら、交換子のdaggerは符号が反転し、反交換子のdaggerは元に戻ります。したがって交換子は反Hermitian、反交換子はHermitianです。
この区別は、不確定性関係の計算でそのまま効きます。交換しないことが量子性の核心であり、反交換子は共分散のような実数的情報を運びます。微分と掛け算の順序差から始まった小さな計算が、Kennard--Robertson型の不確定性関係へつながっていく、という流れがここで見えるようになります。
量子井戸や量子ドットの離散準位から二準位を選び、実験の難しさと説明の飛びを埋めながら量子ビットへつなぎます。
井戸型ポテンシャルに電子を閉じ込めると、許されるエネルギー準位が離散化します。多くの準位があっても、低エネルギー側の二つだけを選び、そこを $|0\rangle$ と $|1\rangle$ と読めば、二準位系としての量子ビットが見えてきます。準位差に合ったレーザーやマイクロ波で遷移を起こす、という発想です。
ただし、言うのは簡単でも、実験は簡単ではありません。不純物、周囲の環境、余分な準位への漏れ、制御信号の精度が効きます。量子ドットも、電子を空間の三方向に閉じ込めることで人工原子のような離散準位を作る装置で、ディスプレイなどで聞く量子ドットとは同じ言葉を共有しながら、量子情報では二準位の制御対象として見られます。
講義では、この話の後に「誰も教えてくれない問題」に触れます。難しい内容を、既習の井戸型ポテンシャルから量子ビットへ、飛びのない形でつなぐことが大事だ、という教育上のメッセージです。量子力学そのものが飛び飛びの準位を扱うからといって、説明まで飛び飛びでよいわけではありません。
箱の中の粒子、周期境界条件、量子ドット、超伝導回路は、別々の豆知識ではなく同じ設計思想の変奏です。自由度を閉じ込め、離散準位を作り、そのうち扱いやすい二つを選びます。そこから量子ビットが始まります。
周期境界条件と磁束量子の考え方を回路へ移し、永久電流状態を人工スピンとして読む道筋をたどります。
リング状の閉じ込めでは、波動関数に周期境界条件が課され、許される波数が整数でラベルされます。これを電気回路の側へ持っていくと、超伝導リングを流れる電流や磁束も離散的な自由度として扱えるようになります。閉じ込めて離散準位を作る、という考え方はここでも同じです。
超伝導では電子がCooper対としてまとまり、リング中を減衰しにくい永久電流として流れます。外部磁束を調整すると、時計回りと反時計回りの電流状態がほぼ同じエネルギーになり、この二つを人工スピンの $|0\rangle,|1\rangle$ として使えます。磁束量子やJosephson接合は、この二状態を作り、混ぜ、制御するための部品です。
講義では、一つの量子ビットを作るだけでも繊細なのに、それを多数並べて相互作用まで調整する装置を作る難しさが語られます。紙の上では $\sigma^z$ や $\sigma^x$ と一文字で書けますが、実機では材料、配線、ノイズ、読み出しが全部ついてきます。式の短さと装置の重さの差を意識すると、量子アニーリングマシンの見え方が変わります。
多数の人工スピンに局所場と結合を与えれば、Ising模型を物理的に作れます。量子アニーリングマシンは、最適化問題を解く箱であると同時に、人工的な多体系ハミルトニアンを動かす実験装置でもあります。
添字付きPauli演算子の省略をほどき、局所場、相互作用、横磁場を巨大な行列を作る装置として読みます。
Ising模型は研究室に入ると突然出てくることがありますが、講義ではそこで立ち止まり、添字付きPauli演算子をテンソル積として具体的に展開します。博士論文の審査でも基本的な量を問われることがある、という余談を交えながら、分からないときは基礎まで戻ってよい、という姿勢が示されます。
$\sigma_1^z$ は本当は $\sigma^z\otimes I$、$\sigma_2^z$ は $I\otimes\sigma^z$ です。物理の板書では恒等演算子が省略されますが、計算機で実装するなら省略されたテンソル積を復元しなければなりません。二量子ビットなら $4\times4$ 行列、三量子ビット、四量子ビットと増えるにつれて、ブロック行列が入れ子になっていきます。
局所場は対角成分を動かし、横磁場は非対角成分を作り、結合は量子ビット間の相互作用を作ります。D-Wave型の装置では、ユーザーが主に $h_i$ と $J_{ij}$ を設定し、横磁場を時間とともに下げることで横磁場Ising模型を動かします。装置は最適化器であると同時に、制御可能なハミルトニアンを持つ量子シミュレーターです。
最後には、ニューラルネットワークが巨大な関数を作るなら、量子コンピュータは巨大な行列を作る装置だ、という見方も語られます。Transformerやattentionとの類似を研究の入口として眺める発想は、Ising模型を単なる古典スピンの模型から、情報処理の広い言葉へつなげてくれます。
古典的だが今も避けられない二準位問題として、横磁場、ギャップ、非断熱遷移の関係を立ち上げます。
量子アニーリングでは、いずれ多量子ビットの横磁場Ising模型を動かします。しかし講義では、その前に一量子ビットの時間依存問題へ戻ります。Landau-Zener遷移は1930年代からある古典的な問題ですが、横磁場、ギャップ、非断熱遷移を一つの式で見るには今でも最良の入口です。
同時に、古いから簡単というわけではありません。講義では、近年にも「Landau-Zener公式を簡単に導く」という論文が出るほど、導出にはいろいろな工夫があると紹介されます。ここでは厳密解の技巧を味わうよりも、手元の道具で二準位ハミルトニアンを書き、何が起きているのかを読めるようにすることを優先します。
設定は、時間に比例して変わる縦磁場 $-\hbar\alpha t\sigma^z$ と、二状態を混ぜる横磁場 $-\hbar g\sigma^x$ です。$z$ と $x$ は交換しないので、縦磁場だけでラベルされていた二つの状態が、原点付近で混ざります。行列としてはたった $2\times2$ ですが、量子アニーリングで何度も出てくる構造がここに凝縮されています。
この問題を避けない理由は、横磁場を入れるとギャップが開く、ギャップが小さいところではゆっくり進める必要がある、という直観を数式で持てるからです。後で大きなIsing模型を見るときも、局所的にはこの二準位の競争を思い出すことになります。
位相しか回らない縦磁場だけの運動と、横磁場で状態が混ざる運動を比べ、公式の指数を読む力を作ります。
横磁場がない場合、縦磁場を時間で反転させても、状態は位相を回すだけです。$|0\rangle$ にいた成分は $|0\rangle$ のまま、$|1\rangle$ にいた成分は $|1\rangle$ のままで、低エネルギー状態のラベルが入れ替わっても、状態そのものは乗り換えられません。これでは最終的な基底状態へたどり着けません。
横磁場を入れると、連立微分方程式の中で二つの振幅が互いに流れ込みます。講義では、横磁場を「揺らす」ものとして説明し、途中で重ね合わせを作るからこそ、片方の状態からもう片方の状態へ移れるのだと強調します。量子アニーリングの横磁場は、ただ量子らしさを足す飾りではなく、状態を移す通路を作る項です。
Landau-Zener公式では、励起状態に残る確率が $\exp(-\pi g^2/\alpha)$ のように指数で抑えられます。横磁場 $g$ が大きければギャップが開き、失敗確率は小さくなります。掃引速度 $\alpha$ が小さければ、ハミルトニアンの変化が遅く、状態は瞬間基底状態を追いやすくなります。
この式を読むだけで、量子アニーリングの基本語彙が一気につながります。コスト関数をハミルトニアンに埋め込み、横磁場で状態を混ぜ、十分ゆっくり変化させて低エネルギー状態へ導く。大きな問題でこの直観を使うには、Landau-Zenerの最小模型を一度は手で見ておく必要があります。
ギャップ解析が手で届く標準問題として、探索の $O(N)$ とGrover型の $O(\sqrt N)$ を比べます。
エネルギーギャップを一般の問題で評価するのは難しいので、講義ではまず、構造が見やすいデータベース探索問題へ移ります。$N$ 個の候補の中に正解が一つだけあります。図書館で目的の本を探すように、一つずつ見ていけば古典的には平均して $O(N)$ の手間がかかります。
Grover探索では、この手間が $O(\sqrt N)$ になります。講義では、量子計算の加速には二乗加速と指数加速があり、二乗加速を小さいものとして雑に扱ってはいけない、と注意が入ります。$N$ が巨大なとき、$N$ と $\sqrt N$ の差は十分に大きく、応用上も研究上も本気で向き合う価値があります。
ゲート型Grover探索では、オラクルと反転操作を交互に作用させて正解の振幅を増幅します。一方、断熱型では、正解状態だけを基底状態にするハミルトニアンと、初期一様重ね合わせを基底状態にするハミルトニアンを用意し、その間を連続的につなぎます。見た目の操作は違いますが、同じ探索問題を相手にしているので、計算量を比べる標準舞台になります。
この補遺で使う目標ハミルトニアン $H_m=I-|m\rangle\langle m|$ は、正解だけをエネルギー0に落とし、それ以外をエネルギー1に置くものです。シンプルすぎるほどシンプルですが、この単純さのおかげで、後のギャップ計算と局所断熱スケジュールが手で追えるようになります。
線形代数の基底選択の自由を使い、正解と非正解の二方向へ巨大な探索空間を畳み込みます。
探索問題をそのまま $N$ 次元の行列として見ると、手計算ではすぐに苦しくなります。講義では、ここで線形代数の基本に戻り、行列表示は一つではない、見たい構造に合わせて基底を選んでよい、と説明されます。抽象的な演算子をどの表示で書くかは、計算する側の自由です。
この問題で本質的なのは、正解状態 $|m\rangle$ と、正解以外を全部均等に重ねた状態 $|r\rangle$ だけです。初期状態も目標ハミルトニアンも、この二次元部分空間の中で閉じています。したがって、巨大な探索空間を、正解と非正解という二つの方向へ畳み込めます。
講義では、線形代数はまず記号の代数として進み、必要になったときだけ具体的な行列表示を選ぶ、という見方も語られます。単位演算子はどの基底でも単位演算子であり、そこが計算の目印になります。基底を選び直しても物理は変わらず、見え方だけが整理されるのです。
この二次元表示に落とすと、ハミルトニアンは人間が読める $2\times2$ 行列になります。そこから固有値差、最小ギャップ、局所断熱スケジュールへ進めます。量子加速の計算は、巨大な行列を力ずくで扱うのではなく、問題の対称性と基底選択を使って手元のサイズまで戻すところから始まります。
ギャップに合わせて速度を変えると、断熱探索でもGrover型の二乗加速へ到達することを確認します。
線形スケジュールでは、最小ギャップだけが全体を支配してしまい、探索時間は $O(N)$ に戻ってしまいます。講義では、そこで局所断熱条件を使い、ギャップが大きいところは速く、ギャップが小さいところは遅く進める、という発想に切り替えます。
探索問題ではギャップの式が分かっているので、$dq/dt$ を $\Delta(q)^2$ に比例させる微分方程式を実際に積分できます。計算すると、全時間の主要項は $\sqrt N$ に比例します。断熱計算でも、進み方をきちんと選べば、ゲート型Grover探索と同じ二乗加速に到達できるわけです。
この結果はかなり励みになります。量子アニーリングは、ただゆっくり動かすだけではなく、問題のギャップ構造に合わせてスケジュールを設計することで性能が変わります。ハミルトニアンの経路と時間配分の両方がアルゴリズムなのだ、という感覚がここで生まれます。
一方で、一般の最適化問題でギャップを解析するのは簡単ではありません。ゲート型アルゴリズムを作るには鋭い構成力が必要で、断熱型ではギャップ評価とスケジュール設計が勝負になります。Grover探索は、うまくいく例であると同時に、一般化の難しさを見せる教材でもあります。
Geman--Geman型の古典的保証に対応するQAの収束定理を、研究プロジェクトの空気とともに読みます。
量子アニーリングの収束定理は、講義では研究史の空気と一緒に語られます。新しい研究成果がすぐ教科書に入ることは少なく、ときには何十年もかけて教育内容になります。だからこそ、2000年代の量子アニーリングの定理を大学院講義の中で扱うことには、前線の知識を早めに共有する意味があります。
背景には、シミュレーテッドアニーリングのGeman--Geman定理に対応する量子側の保証を作りたい、という問いがあります。温度をどう下げればSAが収束するか、という古典側の問いに対して、横磁場をどう下げればQAが基底状態へ追随するかを問います。両者は、確率的な探索と量子的な時間発展という違いを越えて、スケジュール設計の問題として響き合います。
講義では、森田氏と西森氏の仕事が、研究プロジェクトの議論の中から素早く形になったことも語られます。若い研究者が短い周期で定理を出していくような時間感覚、周囲がそれに刺激を受ける雰囲気まで含めて聞くと、定理が単なる完成品ではなく、研究の現場で生まれたものとして見えてきます。
重要なのは、実時間Schrodinger方程式に基づくQAの定理と、量子モンテカルロで古典的に模擬したQAの議論から、同じ種類のスケジュール条件が現れることです。これは一種の普遍性として面白い一方で、最悪の場合の保証だけを見れば量子だから常に速いとは言えない、という冷静な読みも必要です。定理は万能の宣伝文句ではなく、何が保証され、何がまだ分からないかを分けるための足場です。
複雑な係数を支配次数へ整理し、断熱条件を横磁場の微分方程式として積分します。
ここでは、前の節で得たギャップ下限を断熱条件へ代入します。分子にはハミルトニアンを動かす速さ、すなわち $|\dot\Gamma|$ が入り、分母にはエネルギーギャップの二乗が入ります。ギャップが $\Gamma(t)^N$ で下から押さえられるので、条件は $\Gamma(t)$ に関する微分方程式になります。
講義では、係数がかなり複雑に見えても、本質は $\Gamma(t)^N$ の次数にある、と物理らしく整理されます。不等式を厳密に追うことも大事ですが、スケジュールの大きさを知りたい段階では、どの量が支配的かを見ます。この見方を入れると、長い評価式が突然読みやすくなります。
非断熱遷移の振幅 $C_{nm}(t)$ を十分小さくするには、$N|\dot\Gamma|/(A^2\Gamma^{2N})$ を小さく保てばよいです。そこでこの量を小さい定数 $\delta$ に固定すると、$d\Gamma/dt$ と $\Gamma^{2N}$ の微分方程式が得られます。あとは分離変数で積分し、$\Gamma^{-2N}$ の積分から $\Gamma^{-(2N-1)}$ が出ます。
最後に $\Gamma(t)$ について解くと、長時間で $\Gamma(t)\sim t^{-1/(2N-1)}$ というべき減衰スケジュールになります。抽象的な断熱定理が、「横磁場をこの程度ゆっくり下げればよい」という具体的な関数に変わる場面です。講義ではここがクライマックスとして語られ、どんな有限サイズ問題でも基底状態到達を保証できる、という意味が強調されます。
理想的な長時間断熱極限と、実機でSchrodinger dynamicsが見える短い時間窓の緊張を整理します。
収束定理は、理想的な孤立量子系が実時間Schrodinger方程式に従う、という前提に立っています。ところが実機では、量子ビットは外界から完全には切り離せません。ゆっくり動かせば断熱性は良くなりますが、時間を長くするほど熱環境、ノイズ、制御誤差の影響を受けやすくなります。
講義では、この短い理想時間窓が「シンデレラタイム」のように語られます。ある短い時間だけなら、量子アニーリングマシンの振る舞いがSchrodinger方程式によるシミュレーションとよく一致します。その時間内で終わる規模や条件なら、Landau-Zener型の見積もりやギャップにもとづく議論が実験と直接つながります。
この見方は、量子アニーリングマシンを単なる最適化装置としてではなく、多数の量子ビットを持つ量子多体系シミュレーターとして見る方向へ導きます。古典計算機では数十スピン程度で行列サイズが苦しくなるところを、実機の量子デバイスは物理系そのものとして大きなHilbert空間を持ちます。
応用研究が一段落した後に、基礎研究として再び重要になるのは、コヒーレンス時間を伸ばし、Schrodinger dynamicsに近い領域を広げることです。理論が予言した量子多体系の振る舞いを実験で確かめ、予想外の現象が出ればまた理論が動きます。この循環の中に、QAマシンの次の役割があります。
ハバードストラトノビッチ変換を「ハバスト」と呼ぶ研究室文化から入り、二乗を一次へほどく計算の気分を作ります。
最終回の冒頭では、チャット欄の挨拶や試験明けの空気を受けながら、「今日はHopfieldの話であり、ハバスト祭りの日でもある」と場が作られます。ハバードストラトノビッチ変換を短く「ハバスト」と呼び、必要なところで変換を「打つ」という言い回しが、講義全体の合図になっています。
この呼び方は正式名称というより、研究室や周辺分野で自然に育った符丁です。長い名前を毎回言うのではなく、計算の型を共有している人たちの間で短く呼びます。すると、その言葉だけで「二乗を一次化するあの計算だ」と分かるようになります。
講義では、ハバードとストラトノビッチが独立に同種の計算を用いて物性の問題を扱ったことにも触れられます。そこから、スピングラスやレプリカ法の周辺でこの変換がよく使われ、いつの間にか親しみを込めた略称になっていった、という歴史の手触りが添えられます。
一方で、講師は「ただの積分変換です」とも強調します。響きだけで強そうに見えても、実体はガウス積分を逆向きに読む計算手法です。そこが大事で、魔法の言葉ではなく、二乗相互作用をほどくための具体的な道具として使います。
この雑談は、そのままHopfield模型の計算への導入になっています。Hebb則で作ったハミルトニアンは、オーバーラップの二乗を含みます。その二乗があるからスピン和が難しくなります。だからハバストを打つ。冗談のように始まった言葉が、そのまま本編の計算方針を表しているわけです。
さらに、二乗だけでなく高次の項を扱う拡張にも話が及びます。ガンマ関数を使えば三次、四次の項にも似た発想を広げられる。ここには、計算手法を単に覚えるのではなく、自分の問題に合わせて使い直してほしい、という研究者向けのメッセージがあります。
ハミルトニアンの規格化を、エネルギーの示量性と鞍点法のためのスケール合わせとして読みます。
この場面では、Hopfield模型のハミルトニアンに入る係数を修正するところから始まります。$i$ と $j$ の二つの添字で和を取るので、項数はおよそ $N^2$ です。そのままではスピン数に対して大きくなりすぎるため、結合や前係数でスケールを調整します。
狙いは、エネルギーがスピン数 $N$ に比例する形にすることです。物理では、体積や粒子数を2倍にしたらエネルギーも2倍になる、という示量性を大切にします。Hopfield模型でも、ニューロン数を増やしたときに自由エネルギー密度が意味を持つよう、ハミルトニアン全体を $O(N)$ にそろえます。
講義では、こうした修正は現場でよく起こる、と語られます。情報科学の問題を統計力学で解析するとき、まず問題設定の骨格を作り、そのあとで $N$ なのか $\sqrt N$ なのか、どこに $1/N$ を入れるのかを点検します。細かい係数に見えても、熱力学極限を取るときには決定的に効きます。
ここで重要なのは、オーバーラップが経験平均として書かれていることです。$\frac1N\sum_i \xi_i^\mu\sigma_i$ のような平均量を二乗し、それに $N$ をかけると、ハミルトニアンは自然に $O(N)$ になります。平均値を秩序変数にし、全体量を示量的にするという統計力学の作法が見えます。
このスケール合わせは、あとで鞍点法を使うための準備でもあります。指数関数の肩に $N$ 倍された関数を作ると、$N\to\infty$ で最大寄与だけを見ればよくなります。係数を直す作業は、単なる板書の訂正ではなく、計算を可能にするための設計なのです。
情報科学の数理モデルでは、エネルギーは実在する物理量というより、解析のために設計する関数です。だからこそ、どんな規格化にするかを自分で責任を持って決める必要があります。ここに、物理の言葉を情報科学へ持ち込むときの慎重さがあります。
HS変換、スピン和、鞍点法をつなぎ、離散和を連続変数の停留条件へ移す感覚を整理します。
この区間では、分配関数の中に現れるスピン和をどう処理するかが丁寧に説明されます。$\sigma_i=\pm1$ のすべての組合せを入れて足し上げるのが分配関数ですが、二乗項や高次項が残っていると、各スピンを独立に足し上げることができません。
そこでHubbard--Stratonovich変換を使います。ガウス積分を左から右へ実行すれば普通の積分計算ですが、講義ではそれを右から左へ読みます。すでに分かっているガウス積分の公式を逆向きに使い、二乗を補助変数との一次結合へ変えるわけです。
積分を増やすのは、普通なら面倒に見えます。しかしここで本当にやりたいのはスピン和です。離散的な $\pm1$ の総和は組合せ爆発しますが、連続変数の積分ならガウス積分、複素積分、鞍点法などの道具が使えます。難しさを、扱いやすい種類の難しさへ移し替えているのです。
講義では、ガウス測度を $\int Dz$ と書く記法も導入されます。毎回 $\frac{dz}{\sqrt{2\pi}}\exp(-z^2/2)$ と書く代わりに、重み付き積分をひとまとまりの記号として扱います。こういう記法の省略は、計算を見通すための足場になります。
その後、補助変数 $z_\mu$ を $\sqrt N z_\mu$ のようにスケールし直します。これにより、指数関数の肩に $N$ 倍された関数が現れます。$N$ が大きいと、その関数の最大点、すなわち鞍点が支配的になります。
ここで講義の調子は、若い頃に習う置換積分や部分積分から、研究で使う鞍点法へ移ります。積分を最後まで真面目に実行するのではなく、指数関数的に大きくなる寄与だけを見つける。すると、積分問題が微分して停留条件を解く問題へ変わります。
この一連の話は、Hopfield模型だけに閉じません。情報科学の問題に統計力学を持ち込むとき、どの量を $O(N)$ にそろえ、どの変数を秩序変数にし、どこで鞍点法を使えるようにするかが重要です。ハバストは、その全体設計の中心にある変換です。
記憶パターンへの重み付け更新を、query、key、valueによるattentionの直感へつなげます。
この場面では、鞍点方程式から出てきた式と、Hopfieldネットワークの連想記憶の更新式が同じ形を持つことが確認されます。$\beta$ を大きくすると $\tanh$ は急な関数になり、最終的には符号関数に近づきます。つまり、平均場の式が低温では「局所場の符号にそろえる」更新式へ変わります。
講義では、この更新を「いま思い出しかけているものはどのパターンか」と読むことができます。いろいろな記憶パターンに重みをつけて足し合わせ、その符号を見て、もっとも近い記憶を強めていきます。連想記憶は、記憶候補の重み付けを自己強化するダイナミクスとして見えます。
ここからTransformerへの話が入ります。queryは、いまの状態から投げられる問いです。keyは、比較対象となる記憶パターンです。valueは、その記憶をどれだけ取り出すかを表す重みです。Hopfield模型の $z_\mu$ と $\xi^\mu$ をこの言葉で読み替えると、self-attentionの直感に近づきます。
もちろん、Hopfield模型がそのまま現在のTransformerである、という単純な同一視ではありません。違いは大きいです。けれども、たくさんの候補の中から重要度を計算し、その重みを使って状態を更新するという中核には、はっきりした共通感覚があります。
講義では、現代の大規模モデルが難しい構造を増やすより、単純な足し算と掛け算を大量に回す方向へ進んだことにも触れられます。GPUのような並列計算機に合う形で、softmaxや行列積をひたすら回す。複雑な知能のように見えるものが、意外に単純な演算の反復から立ち上がるという見方です。
この雑談の教育的な意味は、古い模型を古いまま終わらせないところにあります。Hopfield模型を学ぶことは、1980年代のニューラルネットワーク史を知るだけではありません。現代のattentionや生成AIを、統計力学の言葉で眺め直す入口にもなります。
Trotter方向の静的近似とレプリカ対称解を、コピー添字によらない解として並べて見ます。
この区間では、量子Hopfield模型をSuzuki--Trotter分解で古典系へ写したあと、どこが難しいのかが説明されます。Trotter方向にコピーされたスピン $\sigma_i^t$ は、隣の時刻スライスと相互作用します。さらに、各サイトにはパターンに由来する場所依存の磁場がかかります。
そのため、厳密には一次元ランダム場Ising模型のような問題を解く必要があります。一次元だから簡単、とは限りません。場所ごとに磁場が違い、Trotter方向の相関も持つので、スピン和は一気に複雑になります。
標準的な進め方として、講義では静的近似が導入されます。補助場 $z_{\mu,t}$ は本来Trotterスライス $t$ ごとに違ってよいのですが、まず $t$ に依存しない $z_\mu$ と置きます。虚時間方向に動かない、静的な解を仮定するわけです。
この発想は、レプリカ法におけるレプリカ対称解とよく似ています。レプリカ法では、同じ乱れを持つコピーを複数用意し、最初にレプリカ番号によらない解を仮定します。Trotter分解とレプリカ法ではコピーの意味が違いますが、「コピー方向に一様な解から始める」という姿勢が共通しています。
ただし、対称性はいつでも守られるわけではありません。レプリカ対称性が破れることもあれば、静的近似が十分でない場合もあります。講義では、仮定した値を微小量 $\delta$ だけずらし、Taylor展開して安定性を見る、という考え方が示されます。
ずらした成分が消えていくなら、その対称な仮定は安定です。逆に、微小なずれが増幅されたり、二次の係数が不安定になったりするなら、より細かい構造を考えなければなりません。ここが、対称性を仮定して楽をすることと、仮定を検査することの境目です。
Parisiによるレプリカ対称性の破れの話にも触れられます。ランダム系は、単一の谷ではなく、多数の谷や階層的な構造を持ちます。Hopfield模型を量子化して解析する計算の途中にも、そのスピングラス的な発想が顔を出します。
量子Hopfield模型から、横磁場を情報処理の制御パラメータとして見る発想へ進みます。
講義では、Hopfield模型を紹介した理由が、量子アニーリングの源流にあるからだと明かされます。古典的な $\pm1$ スピンをPauliの $\hat\sigma^z$ に置き換え、そこへ横磁場 $\Gamma\hat\sigma^x$ をかける。これにより、記憶パターンを古典的に選ぶだけでなく、重ね合わせの中から連想記憶を行う量子Hopfield模型が現れます。
Nonomura--Nishimoriの仕事は、その発想をレプリカ法やスピングラスの方法で解析したものとして位置づけられます。講義では、今の目から見ると軽やかでポップに見える発想でも、計算そのものは一つ一つどっしり進められている、と語られます。面白そうだから横磁場をかける。しかし、かけたあとには、きちんと相図や記憶性能を調べます。
量子系になった瞬間、分配関数は単なるスピン和ではなくトレースになります。そこでSuzuki--Trotter分解を使い、量子系を $M$ 個のコピーを持つ古典系へ写します。各TrotterスライスにはHopfield模型があり、隣り合うスライス同士は横磁場に由来する相互作用 $K$ で結ばれます。
この見方をすると、横磁場のある量子スピン系は、虚時間方向に一つ次元が増えた古典系として扱えます。コピーをたくさん並べる、補助場を入れる、静的近似を置きます。ここで、量子モンテカルロ、レプリカ法、ハバストが同じ計算の部屋に入ってきます。
さらに講義では、Suzuki--Trotter分解を逆向きに読む発想も示されます。ハバストがガウス積分を逆向きに読むのと似て、Trotter方向に並んだ古典スピン列を、縦磁場と横磁場を受ける一スピン量子問題へ戻す。もとの二体相互作用は、補助場によって一体問題へ分解されているので、最後は $2\times2$ のPauli行列を対角化すればよいです。
この対角化から、固有値は $\pm\sqrt{h_i^2+\Gamma^2}$ の形になり、トレースは $2\cosh\{\beta\sqrt{h_i^2+\Gamma^2}\}$ を生みます。$\Gamma=0$ に戻すと古典Hopfield模型の式が再現され、$\Gamma$ があると量子ゆらぎを含む自由エネルギーになります。ここまで来ると、量子Hopfield模型の更新式も鞍点条件から作れます。
期待されたほど記憶容量が劇的に増えたわけではない、という冷静な評価も語られます。それでも重要なのは、横磁場がただの邪魔なノイズではなく、情報処理を進める制御パラメータとして読めるようになったことです。スピンが $+1$ か $-1$ かで迷う状況を、横磁場で本当に迷わせ、最後に横磁場を弱めて答えを確定させます。この発想が量子アニーリングへつながります。
講義の結びでは、量子アニーリングは思いつきで突然出てきたものではない、と強調されます。一スピン、二スピン、有限サイズ、熱力学極限、古典と量子の比較を丁寧に積み上げる。その中で「似ているけれど違う、違うけれど似ている」構造を見つけるから、新しい分野を提案する勇気が生まれます。
さらに、現代のTransformerや大規模モデルを量子系で見たら何が起こるか、という問いも投げかけられます。Hopfield模型からTransformerを眺め、そこに横磁場を入れます。省電力化や新しい計算様式の可能性まで含めて、古典的な連想記憶模型がいまの研究にもつながる題材として置かれます。
2日目: QAOA、量子モンテカルロ、p-spin模型
配信前には、スパースモデリングを料理番組風にたとえる遊びや、QFTをめぐる軽い導入が流れました。全データを律儀に見るのではなく、意味のある成分を選び、ノイズを落とすという発想を、講義前の肩慣らしとして置いています。
配信前には、スパースモデリングを料理番組風にたとえる遊びや、QFTをめぐる軽い導入が流れました。全データを律儀に見るのではなく、意味のある成分を選び、ノイズを落とすという発想を、講義前の肩慣らしとして置いています。
その後、集中講義は夏の風物詩だが、15コマや2単位の時間割を通常学期の外へ押し込むため、日程調整がかなり難しいと語られました。今回は3日間に圧縮され、2日目が体力的にも内容的にも最も苦しい山場だ、という位置づけです。
配信前の時間帯には、スパースモデリングを料理番組のように語る軽い導入が流れます。全データを律儀に測るのではなく、意味のある少数の成分を選び、ノイズを落として本質的なパラメータだけを残す、という発想が冗談まじりに紹介されます。数理的にはL1正則化や圧縮センシングの感覚に近い話です。
その後、集中講義の中日としての体力的な重さにも触れられます。15コマや2単位の時間割を通常学期の外へ押し込むため、集中講義は夏の風物詩である一方、講師にも受講者にもなかなか負荷が大きい形式です。今回は3日間に圧縮されているため、2日目が内容的にも時間的にも山場になります。
このウォームアップは、講義本編に入る前の雑談でありながら、後で出てくる「全部をなめるのではなく、構造を使って探索する」という主題にも重なります。スパース性、最適化、確率的な探索は、量子アニーリングやQAOAと直接同じものではないにせよ、同じ数理的態度を共有しています。
2日目の冒頭では、1日目の配信が大学院講義としてはかなり多く視聴されていることへの驚きが語られました。通常の大学院講義は、受講者が数人から十数人でも珍しくありません。専門的な講義が開かれた形で残ること自体が、研究教育の形を少し変えています。
2日目の冒頭では、1日目の配信が大学院講義としてはかなり多く視聴されていることへの驚きが語られました。通常の大学院講義は、受講者が数人から十数人でも珍しくありません。専門的な講義が開かれた形で残ること自体が、研究教育の形を少し変えています。
同時に、大学院生には自分の専門だけでなく、隣接分野や少し遠い分野にも触れてほしい、というメッセージがありました。QAOAやSQAの話が、量子計算だけでなく統計力学、制御理論、情報統計へ横断していくのは、その姿勢と一致しています。
2日目の冒頭では、1日目の配信が大学院講義としては異例に多く視聴されていることへの驚きが語られます。通常の大学院講義は、分野が尖っているため受講者が数人から十数人程度になることも珍しくありません。その講義が数千回見られている状況は、講師自身にもかなり不思議なものとして受け止められています。
同時に、大学院生には自分の研究だけでなく、隣接分野や少し遠い分野にも触れてほしいというメッセージが語られます。研究が楽しいほど自分の専門に閉じがちですが、別分野の講義を聞くと、今の自分の問題を違う言葉で見直すきっかけになります。
西森先生に研究の進み具合を聞かれた思い出など、大学院時代の軽いエピソードも挟まれます。厳しい研究指導や専門講義の記憶を笑いに変えつつ、QAOA、SQA、p-spin模型を量子計算・統計力学・制御理論の横断として聞いてほしい、という導入になっています。
講義中盤では、QAOAが量子回路のパラメータを変分する方法として説明されました。探索しているのはスピン配置そのものではなく、目的ハミルトニアンとミキサーをどの順番で、どの角度だけ作用させるかです。
講義中盤では、QAOAが量子回路のパラメータを変分する方法として説明されました。探索しているのはスピン配置そのものではなく、目的ハミルトニアンとミキサーをどの順番で、どの角度だけ作用させるかです。
連続時間QAを時間分割し、ハミルトニアンの足し算を交互作用へ分け、さらに各時間幅を自由なパラメータとして解放するとQAOAになります。講義ではこれを、QAをデジタル化し、スケジュールを変分化したものとして整理しています。
この場面では、QAOAが変分量子アルゴリズムとしてどのように定義されるかが説明されます。最適化しているのはスピン配置そのものではなく、目的ハミルトニアンとミキサーをどの順番で、どの角度だけ作用させるかという回路パラメータです。
質問に答える形で、これはまだTrotter分解そのものではなく、まず変分アルゴリズムとしての回路の定義である、と確認されます。ただし、連続時間の量子アニーリングを時間分割し、ハミルトニアンの和を交互作用に分け、各時間幅を自由パラメータとして解放すると、QAOAに近い形が自然に現れます。
講義では、Farhiが量子断熱計算に続いてQAOAにも関わったことに触れながら、同じ発想がアナログな時間発展とデジタルなゲート列の間を行き来している点が強調されます。浅い回路で何ができるか、パラメータ空間のbarren plateauをどう避けるか、といった現在の研究課題への接続も置かれています。
鈴木-トロッター分解のところでは、鈴木増雄先生の仕事と、その流れを受けた統計力学の研究文化が語られました。数学的には指数演算子の分解ですが、量子スピン系の数値計算や量子古典対応へ持ち込んだことで、物理の道具として大きな意味を持ちます。
鈴木-トロッター分解のところでは、鈴木増雄先生の仕事と、その流れを受けた統計力学の研究文化が語られました。数学的には指数演算子の分解ですが、量子スピン系の数値計算や量子古典対応へ持ち込んだことで、物理の道具として大きな意味を持ちます。
講義では、鈴木先生、西森先生、そして大関先生へ続く「道具を整理して、別の問題へ使う」系譜としても紹介されました。既存の式をただ引用するのではなく、この問題に使うと何が見えるかを発見するのが面白い、という研究観がここにあります。
後半の雑談では、海外滞在中に西森先生がSkypeで様子を聞いてくれた、という個人的なエピソードも語られました。こうした人のつながりも含めて、数式の系譜が単なる引用関係ではなく、研究文化として伝わっていることが見えてきます。
鈴木-Trotter分解の話では、単なる指数演算子の公式にとどまらず、量子スピン系を古典統計力学の形に翻訳したことの意味が語られます。非可換なハミルトニアンを分解し、虚時間方向にスライスを増やすことで、量子系が一つ次元の高い古典スピン系として見えるようになります。
鈴木増雄先生の仕事は、数学的な厳密さだけでなく、量子系の数値計算と統計力学の橋として大きな意味を持ちます。講義では、鈴木先生、西森先生、そして大関先生へ続く道具の受け渡しとして、この分解が位置づけられています。研究は式を覚えるだけではなく、既存の道具を別の問題に移したときに何が見えるかを探す営みだ、という語りです。
後半では、海外滞在中に西森先生がSkypeで研究の様子を聞いてくれたという個人的な話も出てきます。式の名前には、その式を作った人、その式を使ってきた人、そしてそれを次の世代へ渡す人の関係が残ります。鈴木-Trotter分解は、この講義ではQAOA、SQA、p-spin模型をつなぐ研究文化の節点として扱われています。
Pontryagin原理は、1950年代の制御理論、特に限られた入力で軌道を制御する問題から生まれたものとして紹介されました。物理ではハミルトニアンが与えられて自然に動く、という見方が多いのに対し、制御理論では外からどう入力するかが主役になります。
Pontryagin原理は、1950年代の制御理論、特に限られた入力で軌道を制御する問題から生まれたものとして紹介されました。物理ではハミルトニアンが与えられて自然に動く、という見方が多いのに対し、制御理論では外からどう入力するかが主役になります。
QAOAとの接続では、制御を連続的に中途半端な値へ保つより、目的ハミルトニアンとミキサーをオン・オフで切り替えるbang-bang制御が自然に出る、と説明されました。講義では、QAOAが後から最適制御の言葉で理解し直されたことも、研究史の面白さとして語られています。
Pontryagin原理の導入では、ロケットや軌道制御のような1950年代の制御理論が背景として語られます。物理ではハミルトニアンが与えられれば自然に状態が動く、という見方が多いのに対し、制御理論では外からどのような入力を入れると目的を最もよく達成できるかが中心になります。
この視点をQAOAに当てると、連続的なスケジュールをなめらかに調整するよりも、目的ハミルトニアンとミキサーハミルトニアンをオン・オフで切り替えるbang-bang制御が自然に出てきます。つまりQAOAの交互ユニタリは、変分回路として発明されたものに見えると同時に、最適制御の言葉で再解釈できます。
講義では、後から別の理論の言葉で既存のアルゴリズムが理解し直される面白さも強調されます。量子アニーリング、QAOA、Pontryagin原理、Schrodinger bridgeは別々の名前を持っていますが、有限時間でどの経路を通すかという問いを共有しています。
休憩明けには、講義ノートを準備している途中で別の計算を思いつき、研究ノートのほうが進んでしまった、という裏話がありました。講義をするために整理しているはずが、整理そのものから新しい問いが生まれる、という研究者らしい場面です。
休憩明けには、講義ノートを準備している途中で別の計算を思いつき、研究ノートのほうが進んでしまった、という裏話がありました。講義をするために整理しているはずが、整理そのものから新しい問いが生まれる、という研究者らしい場面です。
さらに後半では、この集中講義を量子アニーリングの教科書や今後の研究方向につなげたい、という話も出ています。QAOA、Pontryagin原理、Schrodinger bridgeのような話題を同じ流れに置くこと自体が、講義を通じた研究の整理になっています。
休憩明けには、講義ノートを準備しているうちに別の計算を思いつき、研究ノートの方が進んでしまったという裏話が語られます。講義準備は既存の知識を整理する作業であると同時に、つながりを見直すことで新しい問題が立ち上がる時間でもあります。
QAOA、Pontryagin原理、Schrodinger bridgeを同じ流れで並べること自体が、講義を超えて研究の整理になっています。どのハミルトニアンをどの時間だけ作用させるか、ある分布から別の分布へどう移すか、有限時間で理想経路から外れないようにどう補正するかという問いが繰り返し現れます。
この雑談は、量子アニーリングの教科書や今後の研究方向を作るための足場としても位置づけられます。単発の講義で終わらせるのではなく、ここで整理した道具を次の論文や講義、研究テーマへ持っていくという姿勢が見えます。
講義序盤では、最近はSimulated Quantum Annealing、SQAと呼ぶ人が多いが、以前からこの分野にいる人は量子モンテカルロ法と呼ぶことが多い、という軽い世代談がありました。OpenJijなどの文脈から入った人にはSQAという名前のほうが自然で、古くから統計物理で扱っていた人には量子モンテカルロのほうが馴染み深い、という違いです。
講義序盤では、最近はSimulated Quantum Annealing、SQAと呼ぶ人が多いが、以前からこの分野にいる人は量子モンテカルロ法と呼ぶことが多い、という軽い世代談がありました。OpenJijなどの文脈から入った人にはSQAという名前のほうが自然で、古くから統計物理で扱っていた人には量子モンテカルロのほうが馴染み深い、という違いです。
鈴木-トロッター分解の物理的意味は、量子系を虚時間方向に1次元増やした古典系として読むことにあります。講義では、数学的な分解公式としてだけでなく、量子スピン系を古典確率モデルとして扱えるようにした点が強調されました。
SQAと量子モンテカルロの呼び名の違いは、分野への入り口の違いをよく表しています。最近の最適化やOpenJijの文脈から入った人にはSimulated Quantum Annealing、SQAという名前が自然ですが、統計物理や量子スピン系の数値計算から入った人には量子モンテカルロ法という呼び名の方が馴染み深い、という話です。
講義では、言葉の違いが単なる好みではなく、どの問題意識からその手法を見ているかを反映していると説明されます。最適化アルゴリズムとして見るならSQA、量子系の有限温度分配関数をサンプリングする方法として見るなら量子モンテカルロです。どちらも鈴木-Trotter分解を使って、横磁場を持つ量子系を虚時間方向を持つ古典系へ写す点でつながっています。
この変換によって、量子スピン系の分配関数は、Trotter方向に並んだ多数の古典スピンの相互作用として読めるようになります。横磁場が弱いとTrotter方向のスピンは揃いやすく、強いと揺らぎが増えます。この古典対応があるから、量子アニーリングを古典計算機で模擬する道が開ける、という位置づけです。
終盤では、行列要素が確率分布として扱えるかどうかが、量子系を古典的にシミュレーションできるかに関わると説明されました。負の成分や虚数成分が出ると、素直な確率分布へ翻訳できなくなります。
終盤では、行列要素が確率分布として扱えるかどうかが、量子系を古典的にシミュレーションできるかに関わると説明されました。負の成分や虚数成分が出ると、素直な確率分布へ翻訳できなくなります。
stoquasticは、量子系を確率的に扱えるという意味を持つ語として紹介され、non-stoquasticはその対応が難しい場合を指します。日本語にしづらい語でもあり、定義の厳密化にも余地がある、と補足されました。
同時に、横磁場だけだから量子アニーリングはつまらない、という見方には距離が置かれています。基底状態以外のダイナミクスやギャップ、実デバイスで試せる相互作用を考えると、まだ研究すべき問題は多い、という強いメッセージです。
終盤では、stoquasticとnon-stoquasticという言葉が導入されます。量子系を古典確率分布に写すとき、行列要素が非負の重みとして扱えれば、モンテカルロ法でサンプリングする道が開けます。これが確率的に扱える、つまりstoquasticであるという感覚です。
一方、行列要素に負の成分や虚数成分が現れると、確率分布として素直に解釈できません。これは符号問題として現れ、古典シミュレーションを難しくします。non-stoquastic ハミルトニアンが量子計算や量子アニーリングで重要視されるのは、単なる専門用語ではなく、古典計算に翻訳できるかどうかの境目に関わるからです。
ただし講義では、横磁場だけの量子アニーリングを「古典的にシミュレートできるからつまらない」と切り捨てる見方には慎重です。基底状態だけでなく、有限時間ダイナミクス、ギャップ、実デバイス上で試せる相互作用、そしてどの対応が壊れるかを調べること自体に、まだ多くの研究余地があります。
予定時刻を少し越えて、2日目は量子モンテカルロ法とstoquastic/non-stoquasticの話で区切られました。翌日はFokker-Planck方程式、虚時間Schrodinger方程式、拡散モデルとの関係へ進むと予告されます。
予定時刻を少し越えて、2日目は量子モンテカルロ法とstoquastic/non-stoquasticの話で区切られました。翌日はFokker-Planck方程式、虚時間Schrodinger方程式、拡散モデルとの関係へ進むと予告されます。
締めの雑談では、準備しながら自分でも新しく分かったことがあり、研究ネタが二つほど思いついた、と語られました。講義を作ることが、そのまま研究を進めることにもなる、という2日目らしい終わり方です。
2日目の最後は、予定時刻を少し越えながら、量子モンテカルロ法とstoquastic/non-stoquasticの話で区切られます。翌日はFokker-Planck方程式、虚時間Schrodinger方程式、拡散モデルとの対応へ進むと予告され、統計力学から確率過程への橋がかけられます。
締めでは、講義を準備しながら自分でも新しく分かったことがあり、研究ネタが二つほど出てきたと語られます。講義をすることが単に知識を伝えるだけでなく、自分の研究を整理し、新しい方向を見つける行為にもなっていることがよく分かる場面です。
コメントへの反応もあり、途中参加の視聴者からの感想や、場の量子論に似ているという指摘に応答しながら、スピン系でも考え方の核は似ていると補足されます。2日目は、QAOA、SQA、p-spin模型を通して、翌日の拡散モデルへ自然につながる形で閉じられます。
3日目: 拡散モデルと量子アニーリング
3日目の入口では、この講義が物質そのものだけでなく、方法論のつながりを扱う回だと説明されました。日本物理学会の領域11、情報統計力学、スピングラス、経済物理、ニューラルネットワークなどが並び、物性物理の道具が別分野へ広がる様子が強調されています。
3日目の入口では、この講義が物質そのものだけでなく、方法論のつながりを扱う回だと説明されました。日本物理学会の領域11、情報統計力学、スピングラス、経済物理、ニューラルネットワークなどが並び、物性物理の道具が別分野へ広がる様子が強調されています。
量子アニーリング、鈴木-トロッター分解、拡散モデルを別々の話にせず、共通する構造を見つけることがこの日の狙いです。最初に前日の量子古典対応を復習するのは、その橋を架けるためです。
3日目の冒頭では、この講義が物質そのものを扱うだけの物性物理ではなく、物性物理から生まれた方法論が情報・最適化・生成モデルへ広がる様子を扱うものだと説明されます。日本物理学会の領域、スピングラス、情報統計力学、経済物理、ニューラルネットワークなどが並び、境界を越える道具として統計力学が位置づけられます。
領域11の話や、かつての研究会の緊張感にも触れながら、スピングラス周辺の文化が紹介されます。厳しい議論の場で鍛えられた計算手法が、ニューラルネットワークや最適化へ輸入されてきたことが、量子アニーリングの背景にもなっています。
この日の狙いは、量子アニーリング、鈴木-Trotter分解、Fokker-Planck方程式、拡散モデルを別々に眺めるのではなく、同じ数理構造として読むことです。前日の量子古典対応の復習は、そのための足場として置かれています。
横磁場が小さくなると、トロッター方向に並んだコピーは強くそろい、測定しても同じ古典状態が出る、という直観が語られました。横磁場が中途半端なときは、コピー同士が相関を持ちながら揺らぐ状態として見えます。
横磁場が小さくなると、トロッター方向に並んだコピーは強くそろい、測定しても同じ古典状態が出る、という直観が語られました。横磁場が中途半端なときは、コピー同士が相関を持ちながら揺らぐ状態として見えます。
量子デバイスで同じ実験を何度も測る shots や number of reads と、トロッター方向のコピーを重ねて見る感覚が、比喩的に結びつけられました。さらにトレースは、虚時間方向の端をつなぐ周期境界条件として整理されています。
この補足では、Trotter方向に並ぶスピンのコピーを、量子状態を何度も測定しているような感覚で眺める比喩が語られます。横磁場が小さければ古典状態がほぼ確定しているので、何度測っても同じ結果が出るはずです。そのため、Trotter方向のコピーが強く揃うという絵は自然に理解できます。
横磁場が中途半端な場合には、コピー同士が完全には揃わず、相関を持ちながら揺らぎます。これは量子ゆらぎを古典確率モデルに翻訳した姿であり、実デバイスでいうshotsやnumber of readsの直観ともつながります。もちろん厳密に同じ概念ではありませんが、何度も読み出すことで量子状態の分布を観測する、というイメージを助けます。
さらに、分配関数のトレースは虚時間方向の端をつなぐ周期境界条件として説明されます。量子系を古典系へ写すと、Trotter方向という人工的な方向が現れ、その方向の境界条件や相関が量子性を運ぶ役割を持つことが見えてきます。
通常の実時間Schrodinger方程式から時間を虚数方向へ回すと、位相の回転ではなく、エネルギーの高い成分が減衰する式になります。このため、虚時間発展はGibbs-Boltzmann分布や基底状態射影と自然に結びつきます。
通常の実時間Schrodinger方程式から時間を虚数方向へ回すと、位相の回転ではなく、エネルギーの高い成分が減衰する式になります。このため、虚時間発展はGibbs-Boltzmann分布や基底状態射影と自然に結びつきます。
確率流の話では、定常状態と平衡状態の違いも補われました。時間微分が0でも流れが残るなら非平衡定常状態であり、平衡状態には流れそのものが0であることが必要です。詳細釣り合いを破る非平衡モンテカルロ法の直観も、この言葉で見通せます。
ここでは、実時間Schrodinger方程式から虚時間Schrodinger方程式へ移る意味が語られます。実時間では波動関数の位相が回転しますが、時間を虚数方向へ回すと、高エネルギー成分が指数的に減衰します。そのため、虚時間発展は基底状態射影やGibbs-Boltzmann分布と自然につながります。
講義では、スピン系に限らず連続座標の波動関数を使って一般論を説明します。ハミルトニアンを運動エネルギー項とポテンシャル項に分け、時間を虚数化すると、量子力学の式が拡散方程式やFokker-Planck方程式に近い形を帯びます。ここで確率過程との接点が見え始めます。
確率流の話では、定常状態と平衡状態の違いも補われます。時間微分が0で分布が変わらなくても、流れが残っていれば非平衡定常状態です。平衡状態では流れそのものが消える必要があります。この違いは、詳細釣り合いを破る非平衡モンテカルロ法や、確率過程の設計を理解するうえで重要です。
Hopfield模型やニューラルネットワークの容量解析に、スピングラスのレプリカ法が使われてきた歴史が紹介されました。統計力学者がニューラルネットワークを本気で解析しようとしていた時代が、量子アニーリングの背景にあります。
Hopfield模型やニューラルネットワークの容量解析に、スピングラスのレプリカ法が使われてきた歴史が紹介されました。統計力学者がニューラルネットワークを本気で解析しようとしていた時代が、量子アニーリングの背景にあります。
Hopfield模型に横磁場を入れると、温度と横磁場が似た役割を持つことが見えてきます。温度を下げるシミュレーテッドアニーリングから、横磁場を弱める量子アニーリングへ発想を移す道筋は、この情報統計力学の文脈からも読めます。
この歴史談では、Hopfield模型やニューラルネットワークの容量解析に、スピングラスのレプリカ法が使われてきた流れが紹介されます。ニューラルネットワークが現在のように大規模生成AIとして注目される前から、統計力学者たちは記憶容量や相転移を解析対象として扱っていました。
Gardner転移やレプリカ法の話を通じて、情報処理の問題が物理の相転移や自由エネルギーの言葉で見えることが強調されます。90年代前半には、解析できる範囲のニューラルネットワークは統計力学者がかなり調べ尽くした、という時代感も語られます。
その延長で、Hopfield模型に横磁場を入れると、温度を下げるシミュレーテッドアニーリングから、横磁場を弱める量子アニーリングへ発想が移ります。量子アニーリングは、単なる量子計算の話ではなく、情報統計力学の歴史の中からも自然に出てくるものとして位置づけられます。
講義後半の主張は、拡散モデルの物理が虚時間量子アニーリングとして読める、というものでした。画像・動画・音楽などの生成を、確率分布をまねる問題として見直します。
講義後半の主張は、拡散モデルの物理が虚時間量子アニーリングとして読める、というものでした。画像・動画・音楽などの生成を、確率分布をまねる問題として見直します。
Boltzmann machineやHopfield模型は、データ分布をGibbs-Boltzmann分布で表す初期の生成モデルとして紹介されました。ただし平衡化の遅さや表現の制限があり、拡散モデルではデータ分布をいったんノイズで壊し、作りやすいガウス分布から逆向きに戻すという構図に移ります。
scoreは、分布そのものではなく対数密度の勾配を学ぶ量として説明されます。これが逆向きダイナミクスに必要な「どちらへ戻ればデータらしいか」を与えます。
この場面では、拡散モデルの物理を虚時間量子アニーリングとして読む、という3日目の核心が導入されます。画像、動画、音楽などの生成を、データが従う確率分布を真似る問題として捉え直し、その分布をどう作るかという観点から話が進みます。
Boltzmann machineやHopfield模型は、Gibbs-Boltzmann分布を使ってデータ分布を表そうとした初期の生成モデルとして紹介されます。しかしスピングラス的な分布は平衡化が遅く、白黒のプラス・マイナス1の表現にも限界があります。そこで、連続値のデータや深いネットワーク、非平衡過程を利用する方向へ研究が進んでいきます。
拡散モデルでは、まずデータ分布をノイズで壊して作りやすい分布へ送ります。その後、作りやすい分布から逆向きに戻すことで、データらしいサンプルを生成します。この逆向き過程で必要になるのがscore、すなわち対数密度の勾配です。分布そのものを丸ごと学ぶのではなく、どちらへ戻ればデータらしいかを与えるベクトル場を学ぶ、というのが重要な見方です。
逆向き過程では、単に力の符号を反転するだけでは足りず、scoreに対応する項を足す必要があります。講義では、この補正が虚時間量子アニーリングにおける反断熱項に対応すると説明されました。
逆向き過程では、単に力の符号を反転するだけでは足りず、scoreに対応する項を足す必要があります。講義では、この補正が虚時間量子アニーリングにおける反断熱項に対応すると説明されました。
さらに、森田・西森のスケジュール条件を拡散モデルのノイズスケジュールへ輸入できる可能性が語られます。対象が違っても同じ数理構造が見つかれば、片方で得た知見をもう片方へ持っていける、というのが3日目全体の研究観です。
最後は、9月や10月を新しいことを始める区切りにしてほしい、という柔らかいメッセージで締められました。講義を受けた刺激を、勉強でも研究でも、次の一歩につなげてほしいという結びです。
この長い終盤では、拡散モデルの逆向き過程と反断熱項の対応が詳しく語られます。元の確率過程をただ時間反転するだけでは、有限時間では望む分布を正しくたどれません。そこで、現在の分布に押し戻す補正としてscore項が必要になります。
講義では、この補正が虚時間量子アニーリングでいうcounter-diabatic項に対応すると説明されます。ゆっくり行えば各時刻の平衡分布や基底状態を追えるはずですが、現実の生成過程は有限時間で走ります。そのずれを抑えるために追加される項が、拡散モデルではscoreとして現れます。
ただし、scoreは厳密には分からないため、ニューラルネットワークで近似的に学習します。これは量子アニーリングで厳密な反断熱項をそのまま実装できず、Sels-Polkovnikov型の変分原理で近似する状況とよく似ています。学習誤差やモデルの表現力が、生成精度の限界として現れるわけです。
さらに、森田・西森のスケジュール改善の考え方を拡散モデルのノイズスケジュールへ輸入できるのではないか、という展望も語られます。対象は量子アニーリングと生成モデルで違っていても、同じ数理構造を見つければ、片方で得た知見をもう片方へ運べます。最後は、講義をきっかけに9月や10月から新しい勉強や研究を始めてほしい、というメッセージで締められます。