3日目: 拡散モデルと量子アニーリング
この日の式の地図
3日目の狙いは、量子アニーリング、確率過程、拡散モデルを「時間発展で分布を運ぶ」という同じ言葉で読むことです。実時間の量子力学から虚時間へ移り、そこからFokker-Planck方程式、Langevin方程式、SUSY因子化、score-based diffusionへ進みます。
| 段階 | 式の役割 | 対応ページ |
|---|---|---|
| 虚時間QA | 実時間Schrodinger方程式を虚時間に回転する | 科学大 p.22 / 20260903 p.13 |
| Fokker-Planck | 科学大 p.22-23 / 20260903 p.13 | |
| SUSY分解 | 任意の基底分布を持つハミルトニアンを作る | 科学大 p.23-24 / 20260903 p.14 |
| 拡散モデル | データ分布からガウス分布へ、そして逆向き生成へ | 科学大 p.24-25 / 20260903 p.14-15 |
| 反断熱項との接続 | score項を、分布に追随させる補正項として読む | 科学大 p.25 / 20260903 p.15 |
コラム 3日目 0:26:09-0:29:21 / 0:29:21-0:35:49
物性物理という名前で、方法を統合する
3日目の入口では、この講義が物質そのものだけでなく、方法論のつながりを扱う回だと説明されました。日本物理学会の領域11、情報統計力学、スピングラス、経済物理、ニューラルネットワークなどが並び、物性物理の道具が別分野へ広がる様子が強調されています。
量子アニーリング、鈴木-トロッター分解、拡散モデルを別々の話にせず、共通する構造を見つけることがこの日の狙いです。最初に前日の量子古典対応を復習するのは、その橋を架けるためです。
3日目の入口では、この講義が物質そのものだけでなく、方法論のつながりを扱う回だと説明されました。日本物理学会の領域11、情報統計力学、スピングラス、経済物理、ニューラルネットワークなどが並び、物性物理の道具が別分野へ広がる様子が強調されています。
量子アニーリング、鈴木-トロッター分解、拡散モデルを別々の話にせず、共通する構造を見つけることがこの日の狙いです。最初に前日の量子古典対応を復習するのは、その橋を架けるためです。
3日目の冒頭では、この講義が物質そのものを扱うだけの物性物理ではなく、物性物理から生まれた方法論が情報・最適化・生成モデルへ広がる様子を扱うものだと説明されます。日本物理学会の領域、スピングラス、情報統計力学、経済物理、ニューラルネットワークなどが並び、境界を越える道具として統計力学が位置づけられます。
領域11の話や、かつての研究会の緊張感にも触れながら、スピングラス周辺の文化が紹介されます。厳しい議論の場で鍛えられた計算手法が、ニューラルネットワークや最適化へ輸入されてきたことが、量子アニーリングの背景にもなっています。
この日の狙いは、量子アニーリング、鈴木-Trotter分解、Fokker-Planck方程式、拡散モデルを別々に眺めるのではなく、同じ数理構造として読むことです。前日の量子古典対応の復習は、そのための足場として置かれています。
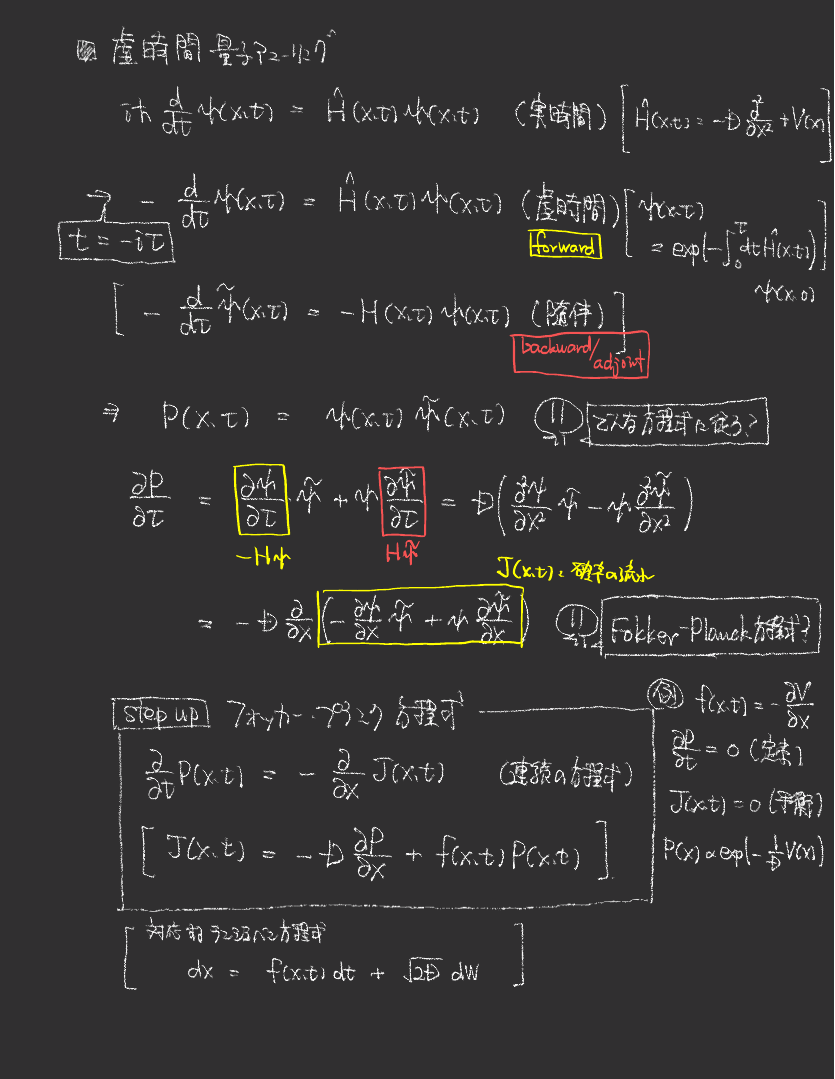
1. 実時間から虚時間へ
出発点は、1次元の量子ハミルトニアン
です。実時間のSchrodinger方程式は
ですが、時間を虚数方向へ回す
と、虚時間方程式
が得られます。形式解は、時間順序を省略して書けば
です。実時間では位相が回りますが、虚時間では高いエネルギー成分が指数的に減衰します。そのため、虚時間発展は基底状態射影やGibbs重みと相性がよくなります。
同時に、随伴の向きに進む波動関数
と
を並べています。後者は
と同じです。これらを掛け合わせて
を作ると、確率分布のような量が現れます。
コラム 3日目 0:40:53-0:41:48 / 0:41:48-0:56:24
トロッター方向を「何度も測る」感覚で眺める
横磁場が小さくなると、トロッター方向に並んだコピーは強くそろい、測定しても同じ古典状態が出る、という直観が語られました。横磁場が中途半端なときは、コピー同士が相関を持ちながら揺らぐ状態として見えます。
量子デバイスで同じ実験を何度も測る shots や number of reads と、トロッター方向のコピーを重ねて見る感覚が、比喩的に結びつけられました。さらにトレースは、虚時間方向の端をつなぐ周期境界条件として整理されています。
横磁場が小さくなると、トロッター方向に並んだコピーは強くそろい、測定しても同じ古典状態が出る、という直観が語られました。横磁場が中途半端なときは、コピー同士が相関を持ちながら揺らぐ状態として見えます。
量子デバイスで同じ実験を何度も測る shots や number of reads と、トロッター方向のコピーを重ねて見る感覚が、比喩的に結びつけられました。さらにトレースは、虚時間方向の端をつなぐ周期境界条件として整理されています。
この補足では、Trotter方向に並ぶスピンのコピーを、量子状態を何度も測定しているような感覚で眺める比喩が語られます。横磁場が小さければ古典状態がほぼ確定しているので、何度測っても同じ結果が出るはずです。そのため、Trotter方向のコピーが強く揃うという絵は自然に理解できます。
横磁場が中途半端な場合には、コピー同士が完全には揃わず、相関を持ちながら揺らぎます。これは量子ゆらぎを古典確率モデルに翻訳した姿であり、実デバイスでいうshotsやnumber of readsの直観ともつながります。もちろん厳密に同じ概念ではありませんが、何度も読み出すことで量子状態の分布を観測する、というイメージを助けます。
さらに、分配関数のトレースは虚時間方向の端をつなぐ周期境界条件として説明されます。量子系を古典系へ写すと、Trotter方向という人工的な方向が現れ、その方向の境界条件や相関が量子性を運ぶ役割を持つことが見えてきます。
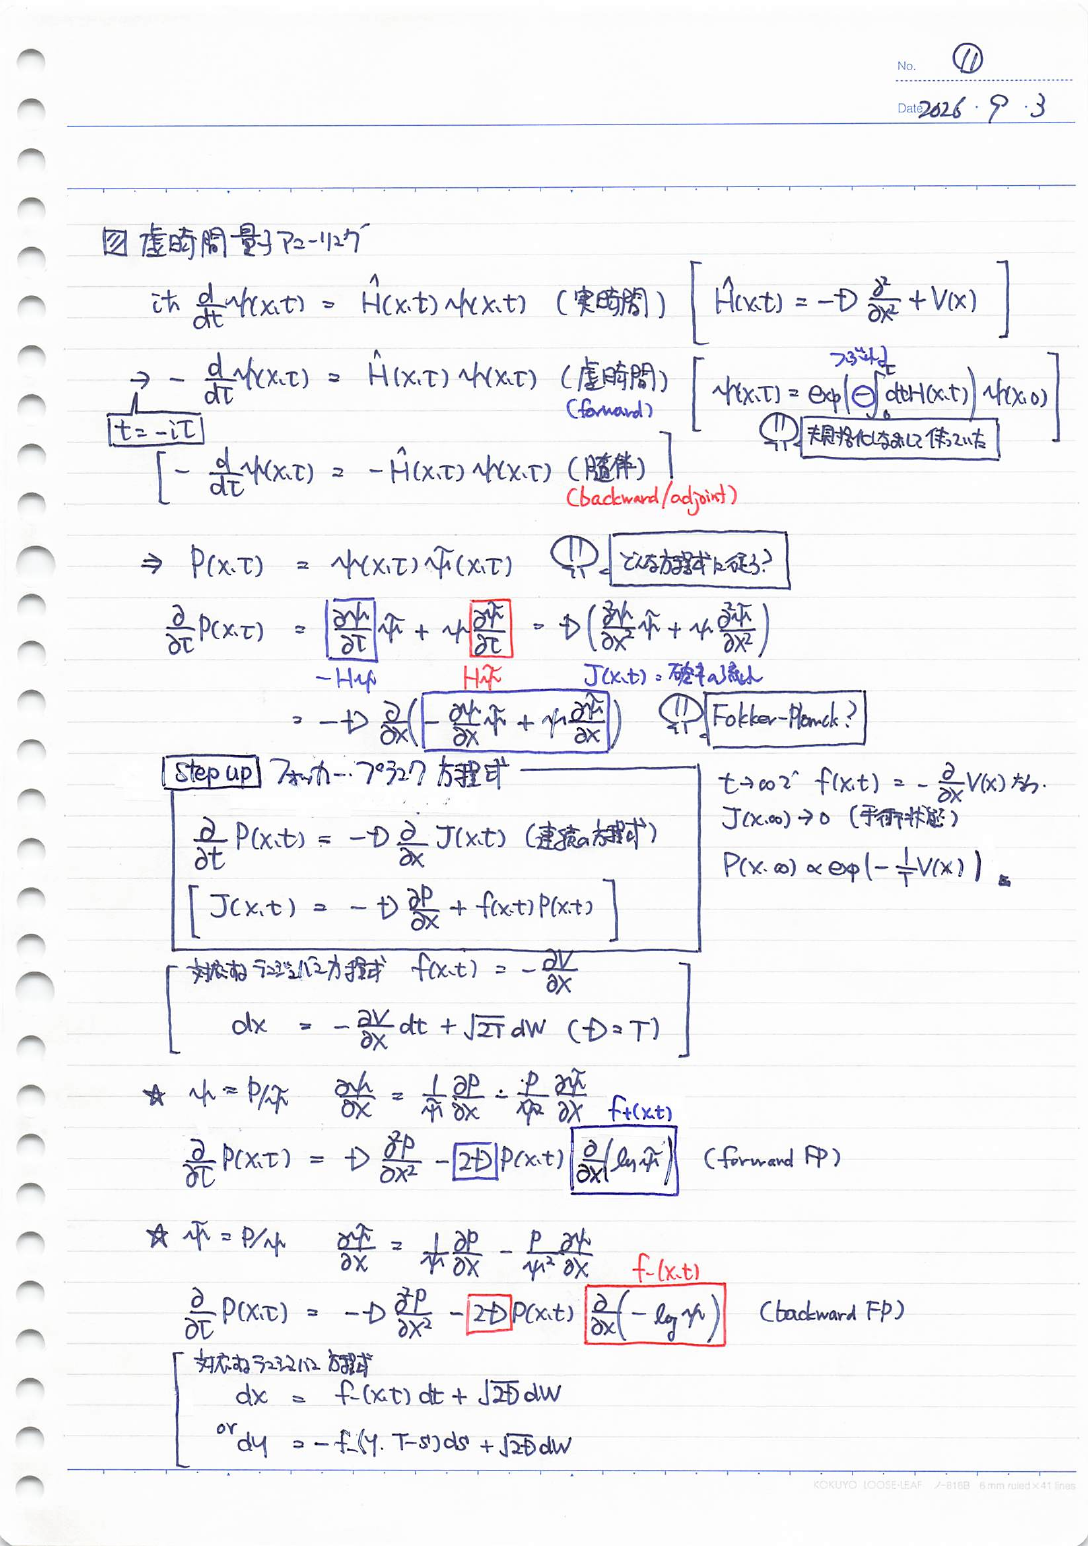
2. 確率密度から確率流を作る
です。
となります。これは全微分の形にまとめられて、
という連続の方程式になります。確率流は
の形で書けます。したがってFokker-Planck方程式は
です。
対応するLangevin方程式は
です。力がポテンシャルから
で与えられるとき、平衡状態では確率流が消えます。
この条件から
が出ます。講義中には、定常状態と平衡状態の違いも強調されました。
なら定常状態ですが、平衡状態にはさらに
が必要です。
3. forward FPとbackward FP
板書では、
まず
と書くと、
です。これを使うと
となります。これは
をドリフトとするforward Fokker-Planck方程式です。
一方で
と書くと、
というbackward側の式が出ます。対応するドリフトは
です。前向きと後ろ向きで拡散項の符号や時間の向きが変わるため、板書では
または、逆向き時間
と書く見方が示されています。
ここで見えているのは、同じ
コラム 3日目 2:12:30-2:28:03 / 2:28:03-2:29:24
虚時間にすると、確率過程の顔が見える
通常の実時間Schrodinger方程式から時間を虚数方向へ回すと、位相の回転ではなく、エネルギーの高い成分が減衰する式になります。このため、虚時間発展はGibbs-Boltzmann分布や基底状態射影と自然に結びつきます。
確率流の話では、定常状態と平衡状態の違いも補われました。時間微分が0でも流れが残るなら非平衡定常状態であり、平衡状態には流れそのものが0であることが必要です。詳細釣り合いを破る非平衡モンテカルロ法の直観も、この言葉で見通せます。
通常の実時間Schrodinger方程式から時間を虚数方向へ回すと、位相の回転ではなく、エネルギーの高い成分が減衰する式になります。このため、虚時間発展はGibbs-Boltzmann分布や基底状態射影と自然に結びつきます。
確率流の話では、定常状態と平衡状態の違いも補われました。時間微分が0でも流れが残るなら非平衡定常状態であり、平衡状態には流れそのものが0であることが必要です。詳細釣り合いを破る非平衡モンテカルロ法の直観も、この言葉で見通せます。
ここでは、実時間Schrodinger方程式から虚時間Schrodinger方程式へ移る意味が語られます。実時間では波動関数の位相が回転しますが、時間を虚数方向へ回すと、高エネルギー成分が指数的に減衰します。そのため、虚時間発展は基底状態射影やGibbs-Boltzmann分布と自然につながります。
講義では、スピン系に限らず連続座標の波動関数を使って一般論を説明します。ハミルトニアンを運動エネルギー項とポテンシャル項に分け、時間を虚数化すると、量子力学の式が拡散方程式やFokker-Planck方程式に近い形を帯びます。ここで確率過程との接点が見え始めます。
確率流の話では、定常状態と平衡状態の違いも補われます。時間微分が0で分布が変わらなくても、流れが残っていれば非平衡定常状態です。平衡状態では流れそのものが消える必要があります。この違いは、詳細釣り合いを破る非平衡モンテカルロ法や、確率過程の設計を理解するうえで重要です。
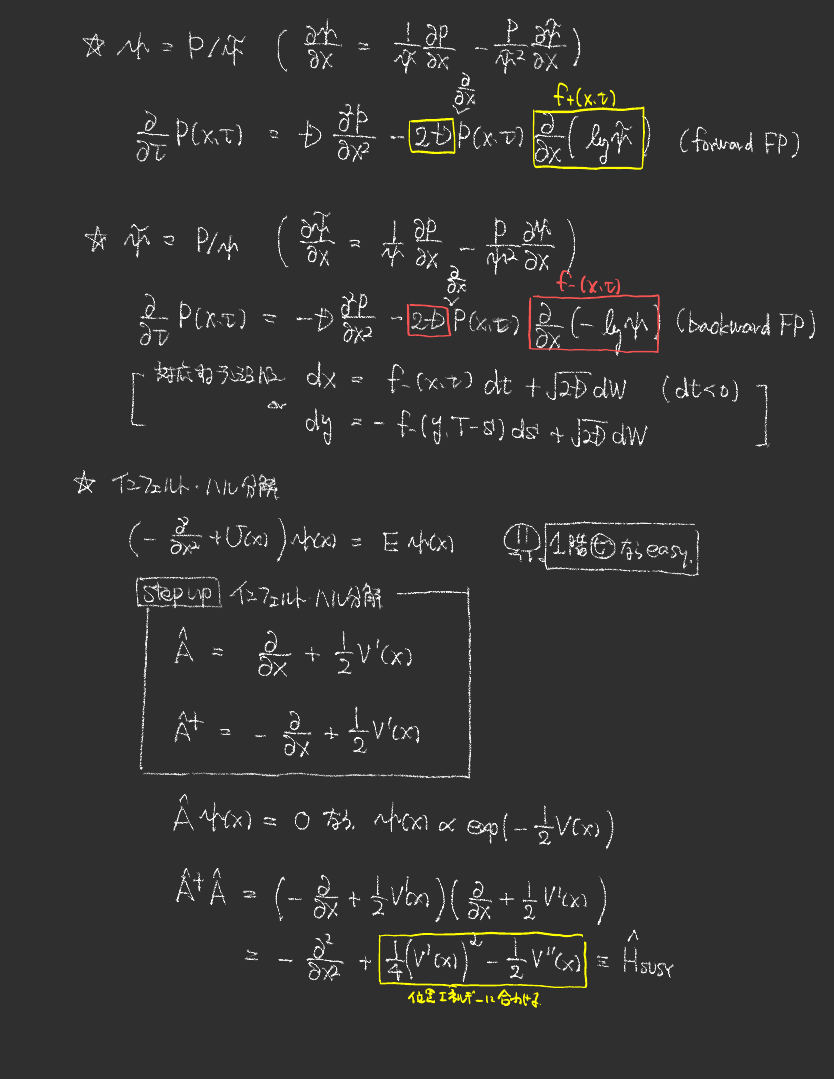
4. SUSY量子力学として見る
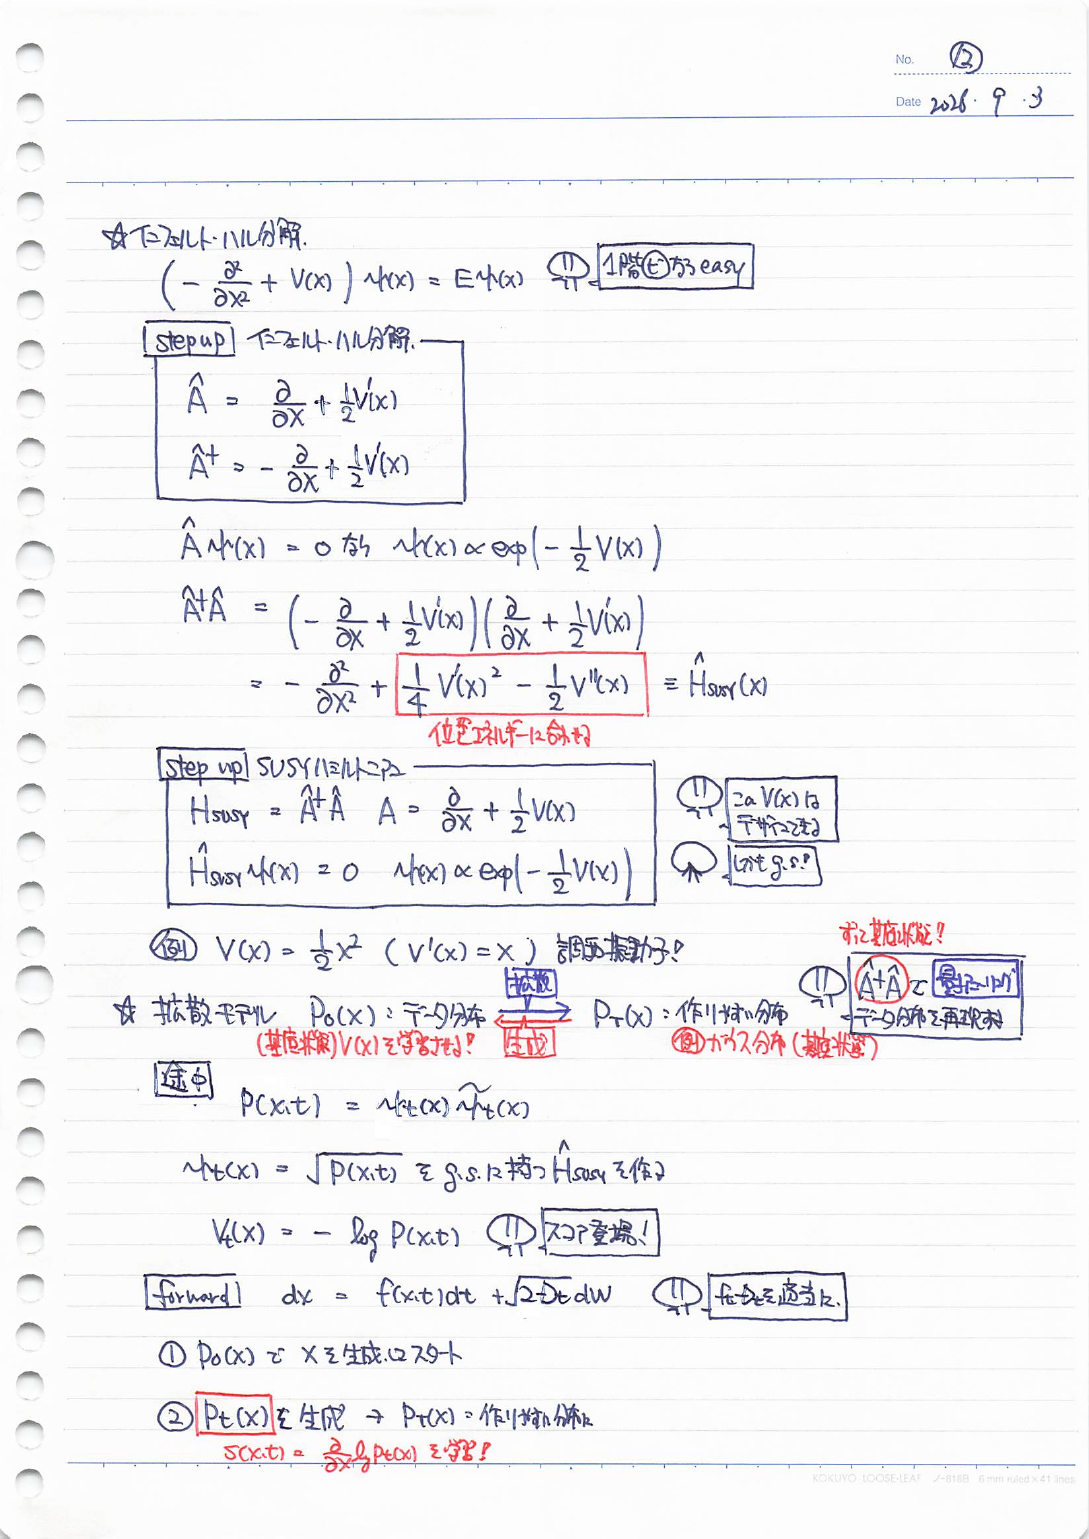
次に、Fokker-Planck方程式を量子力学的なハミルトニアンとして見やすくするため、Infeld-Hull分解、つまりSUSY量子力学の因子化を使います。
固有値問題を
と書きます。板書では、ある関数
を定義しています。もし
なら、
なので
です。
この
であり、
となります。したがって
は非負で、
を満たします。つまり、欲しい分布の平方根を基底状態に持つハミルトニアンを構成できます。
例として
なら
で、調和振動子型の因子化になります。講義では、調和振動子の生成消滅演算子もこの構造の一例として位置づけられました。
5. 分布を基底状態として持つハミルトニアン
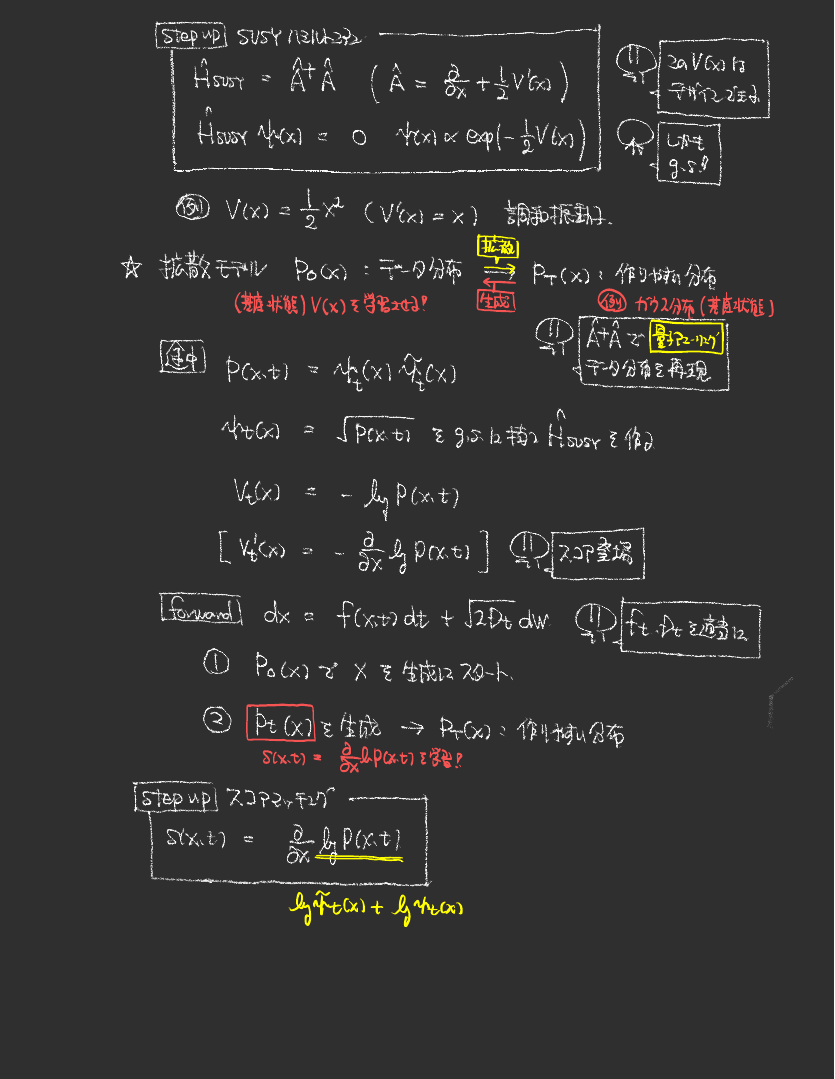
拡散モデルとの接続では、時刻ごとの確率分布
を基底状態として持つSUSYハミルトニアンを作るなら、
で、対称な場合には
このとき、SUSY分解で使うポテンシャルは
です。なぜなら
だからです。
量子力学の形に戻すと、各時刻の分布
があり、
を満たします。これが「確率分布を基底状態として持つハミルトニアンを作る」という意味です。
コラム 3日目 1:46:27-1:49:17 / 1:49:17-1:51:50
情報統計力学から量子アニーリングへ
Hopfield模型やニューラルネットワークの容量解析に、スピングラスのレプリカ法が使われてきた歴史が紹介されました。統計力学者がニューラルネットワークを本気で解析しようとしていた時代が、量子アニーリングの背景にあります。
Hopfield模型に横磁場を入れると、温度と横磁場が似た役割を持つことが見えてきます。温度を下げるシミュレーテッドアニーリングから、横磁場を弱める量子アニーリングへ発想を移す道筋は、この情報統計力学の文脈からも読めます。
Hopfield模型やニューラルネットワークの容量解析に、スピングラスのレプリカ法が使われてきた歴史が紹介されました。統計力学者がニューラルネットワークを本気で解析しようとしていた時代が、量子アニーリングの背景にあります。
Hopfield模型に横磁場を入れると、温度と横磁場が似た役割を持つことが見えてきます。温度を下げるシミュレーテッドアニーリングから、横磁場を弱める量子アニーリングへ発想を移す道筋は、この情報統計力学の文脈からも読めます。
この歴史談では、Hopfield模型やニューラルネットワークの容量解析に、スピングラスのレプリカ法が使われてきた流れが紹介されます。ニューラルネットワークが現在のように大規模生成AIとして注目される前から、統計力学者たちは記憶容量や相転移を解析対象として扱っていました。
Gardner転移やレプリカ法の話を通じて、情報処理の問題が物理の相転移や自由エネルギーの言葉で見えることが強調されます。90年代前半には、解析できる範囲のニューラルネットワークは統計力学者がかなり調べ尽くした、という時代感も語られます。
その延長で、Hopfield模型に横磁場を入れると、温度を下げるシミュレーテッドアニーリングから、横磁場を弱める量子アニーリングへ発想が移ります。量子アニーリングは、単なる量子計算の話ではなく、情報統計力学の歴史の中からも自然に出てくるものとして位置づけられます。
6. 拡散モデルのforward過程
拡散モデルでは、データ分布
という向きで描かれています。
forward過程は
です。
です。
この過程は生成のためには逆向きに解きたいものです。つまり、作りやすい
生成モデルの歴史と、VAE・GAN・拡散モデルにおける量子アニーラの役割は、生成モデルの補遺で比較します。
7. scoreを学ぶ
拡散モデルで学習される中心量は、確率密度そのものではなく、その対数微分です。板書では
を「スコア」として学習する、と書かれています。
です。したがって
と分解されます。
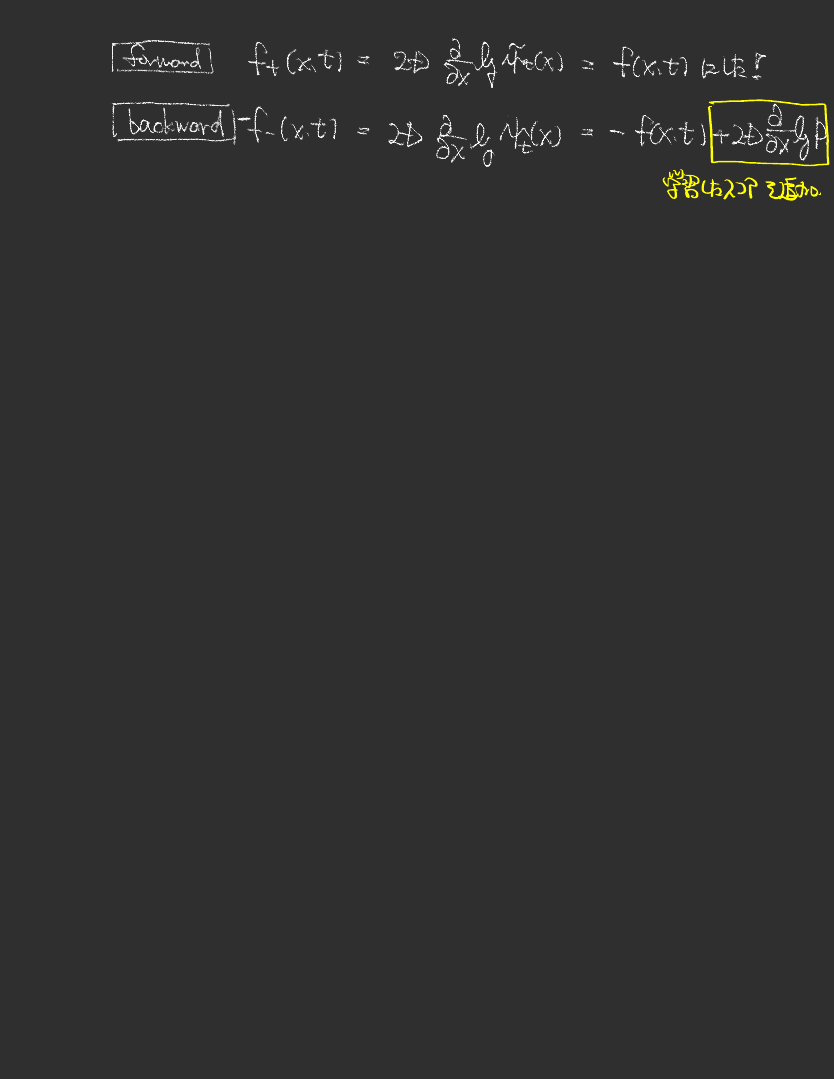
forward側のドリフトを
と置くと、講義の記法ではこれが
に対応します。一方でbackward側は
です。両者を足すと
です。したがって
とも書けます。
逆向き時間で生成過程を走らせると、板書の符号規約では
の形になります。ここで追加された
が、学習したscoreから作る補正項です。通常の拡散モデルの記法では、
ボルツマンマシンの学習則と量子アニーラによる負相の計算、フリーズ現象、時間依存摂動論による温度の設計は、ボルツマンマシンの補遺で詳しく扱います。
コラム 3日目 3:23:03-3:24:06 / 3:24:06-3:44:41 / 3:44:41-3:47:41
Boltzmann machineから拡散モデルへ
講義後半の主張は、拡散モデルの物理が虚時間量子アニーリングとして読める、というものでした。画像・動画・音楽などの生成を、確率分布をまねる問題として見直します。
Boltzmann machineやHopfield模型は、データ分布をGibbs-Boltzmann分布で表す初期の生成モデルとして紹介されました。ただし平衡化の遅さや表現の制限があり、拡散モデルではデータ分布をいったんノイズで壊し、作りやすいガウス分布から逆向きに戻すという構図に移ります。
scoreは、分布そのものではなく対数密度の勾配を学ぶ量として説明されます。これが逆向きダイナミクスに必要な「どちらへ戻ればデータらしいか」を与えます。
この場面では、拡散モデルの物理を虚時間量子アニーリングとして読む、という3日目の核心が導入されます。画像、動画、音楽などの生成を、データが従う確率分布を真似る問題として捉え直し、その分布をどう作るかという観点から話が進みます。
Boltzmann machineやHopfield模型は、Gibbs-Boltzmann分布を使ってデータ分布を表そうとした初期の生成モデルとして紹介されます。しかしスピングラス的な分布は平衡化が遅く、白黒のプラス・マイナス1の表現にも限界があります。そこで、連続値のデータや深いネットワーク、非平衡過程を利用する方向へ研究が進んでいきます。
拡散モデルでは、まずデータ分布をノイズで壊して作りやすい分布へ送ります。その後、作りやすい分布から逆向きに戻すことで、データらしいサンプルを生成します。この逆向き過程で必要になるのがscore、すなわち対数密度の勾配です。分布そのものを丸ごと学ぶのではなく、どちらへ戻ればデータらしいかを与えるベクトル場を学ぶ、というのが重要な見方です。
8. 反断熱項としてのscore補正
拡散モデルの逆過程は、虚時間量子アニーリングの反断熱項として読むことができます。
量子アニーリングでは、作りやすい基底状態から、目的ハミルトニアンの基底状態へ有限時間で運びます。拡散モデルでは、作りやすいガウス分布から、データ分布へ有限時間で戻します。どちらも、途中の時刻ごとの目標状態または分布に追随させたいです。
虚時間側で時刻ごとの分布
に比例する項を逆過程のドリフトへ足します。この「各時刻の分布へ押し戻す補正」が、反断熱項に対応します。
多次元の拡散モデルでよく使われる記法では、forward SDEを
と書くと、reverse SDEは時間向きを反転した上で
の形になります。1次元で
この式は、生成AIの技術的な話にとどまりません。量子アニーリングで培われた断熱・反断熱・スケジュール設計の考え方を、拡散モデルのノイズスケジュールや生成誤差に移植できるかもしれない、という研究の入口になります。
Score ハミルトニアンとCD項
score補正と反断熱項の対応は、確率密度を平方根分布としてヒルベルト空間へ持ち上げると明確になります。まず時刻
としてヒルベルト空間上の状態に持ち上げます。ここで
となります。つまりscoreは、逆向きSDEに足す経験的な補正というだけではありません。平方根分布を基底状態にするScore ハミルトニアンのポテンシャルを決める量でもあります。分布を確率過程として見るか、平方根を波動関数のように見るかで、同じ
もう少し細かく見ると、確率密度を2つの虚時間振幅の積
として分解します。forwardのドリフトを
という追加項が現れます。ここで
この横方向成分をKato-Berry型の形に持ち上げると、
となります。ここまでをまとめると、拡散モデルのscore補正は、Fokker--Planck方程式の水準では「逆向きドリフトを正しい密度経路へ押し戻す力」です。一方、平方根分布を動く基底状態として見ると、その同じ力が、有限時間で経路から外れないためのCD接続として現れます。これが、score項を虚時間量子アニーリングの反断熱項として読む理由です。
横磁場の減衰スケジュールと生成誤差
この対応ができると、生成誤差も量子アニーリングの言葉で議論できます。理想的には、generationは単純な事前分布からデータ分布へ戻るあいだ、各
虚時間発展では、始点側で生じた励起はギャップによって指数的に減衰します。そのため、代数的に残りやすいのはデータ端点側の寄与です。そこで森田・西森型の境界消去を、generationの終点
です。
ただし、ここで重要なのは「スケジュールだけで何でも治る」という話ではないことです。拡散モデルでは真のscore
と書くと、scoreの誤差
このため生成誤差は、少なくとも概念的には
のように読むことができます。ここで
第1項は有限時間でスケジュールを走らせることによる漏れで、森田・西森型の端点条件で改善できる部分です。第2項はscoreを学習で近似したことによる床です。どれだけスケジュールを滑らかにしても、scoreがずれていれば、最終的にはこの床にぶつかります。
さらに、量子アニーリングで小さいギャップが危険だったのと同じく、Score ハミルトニアンのギャップが小さい場所では生成も不安定になります。ギャップ
のように、ギャップの小さい領域とデータ端点の近くで丁寧に進む形へ変えることができます。生成AIの実装では、これはノイズスケジュール、サンプリングステップの割り振り、学習済みscoreの信用度を同時に見るという設計指針になります。量子アニーリングの誤差評価は、この対応を通じて、拡散モデルの生成誤差を評価するための言葉にもなります。
コラム 3日目 3:57:53-4:02:33 / 4:02:33-4:19:40 / 4:19:40-4:24:40 / 5:54:43-5:57:40
同じ数理構造を見つけたら、知見を輸入できる
逆向き過程では、単に力の符号を反転するだけでは足りず、scoreに対応する項を足す必要があります。この補正は、虚時間量子アニーリングにおける反断熱項に対応します。
森田・西森のスケジュール条件は、拡散モデルのノイズスケジュールにも輸入できます。対象が違っても同じ数理構造が見つかれば、片方で得た知見をもう片方へ持っていける、という研究観がここにあります。
9月や10月を新しいことを始める区切りにする、という柔らかい呼びかけも、この研究観と響き合います。数式の対応を眺めて終わるのではなく、勉強でも研究でも、次の一歩につなげるための結びです。
逆向き過程では、単に力の符号を反転するだけでは足りず、scoreに対応する項を足す必要があります。この補正は、虚時間量子アニーリングにおける反断熱項に対応します。
森田・西森のスケジュール条件は、拡散モデルのノイズスケジュールにも輸入できます。対象が違っても同じ数理構造が見つかれば、片方で得た知見をもう片方へ持っていける、という研究観がここにあります。
9月や10月を新しいことを始める区切りにする、という柔らかい呼びかけも、この研究観と響き合います。数式の対応を眺めて終わるのではなく、勉強でも研究でも、次の一歩につなげるための結びです。
拡散モデルの逆向き過程と反断熱項は、有限時間で目標分布をたどるという一点でつながります。元の確率過程をただ時間反転するだけでは、望む分布を正しくたどれません。そこで、現在の分布に押し戻す補正としてscore項が必要になります。
この補正は、虚時間量子アニーリングでいうcounter-diabatic項に対応します。ゆっくり行えば各時刻の平衡分布や基底状態を追えるはずですが、現実の生成過程は有限時間で走ります。そのずれを抑えるために追加される項が、拡散モデルではscoreとして現れます。
ただし、scoreは厳密には分からないため、ニューラルネットワークで近似的に学習します。これは量子アニーリングで厳密な反断熱項をそのまま実装できず、Sels-Polkovnikov型の変分原理で近似する状況とよく似ています。学習誤差やモデルの表現力が、生成精度の限界として現れるわけです。
森田・西森のスケジュール改善の考え方は、拡散モデルのノイズスケジュールへも移せます。対象は量子アニーリングと生成モデルで違っていても、同じ数理構造を見つければ、片方で得た知見をもう片方へ運べます。ここには、9月や10月から新しい勉強や研究を始めてほしい、という読者へのメッセージも重なります。
Aharonovの二状態ベクトル形式からscoreを読み直す議論は、補遺: アハラノフの2ベクトル形式からscoreを見る にまとめました。